
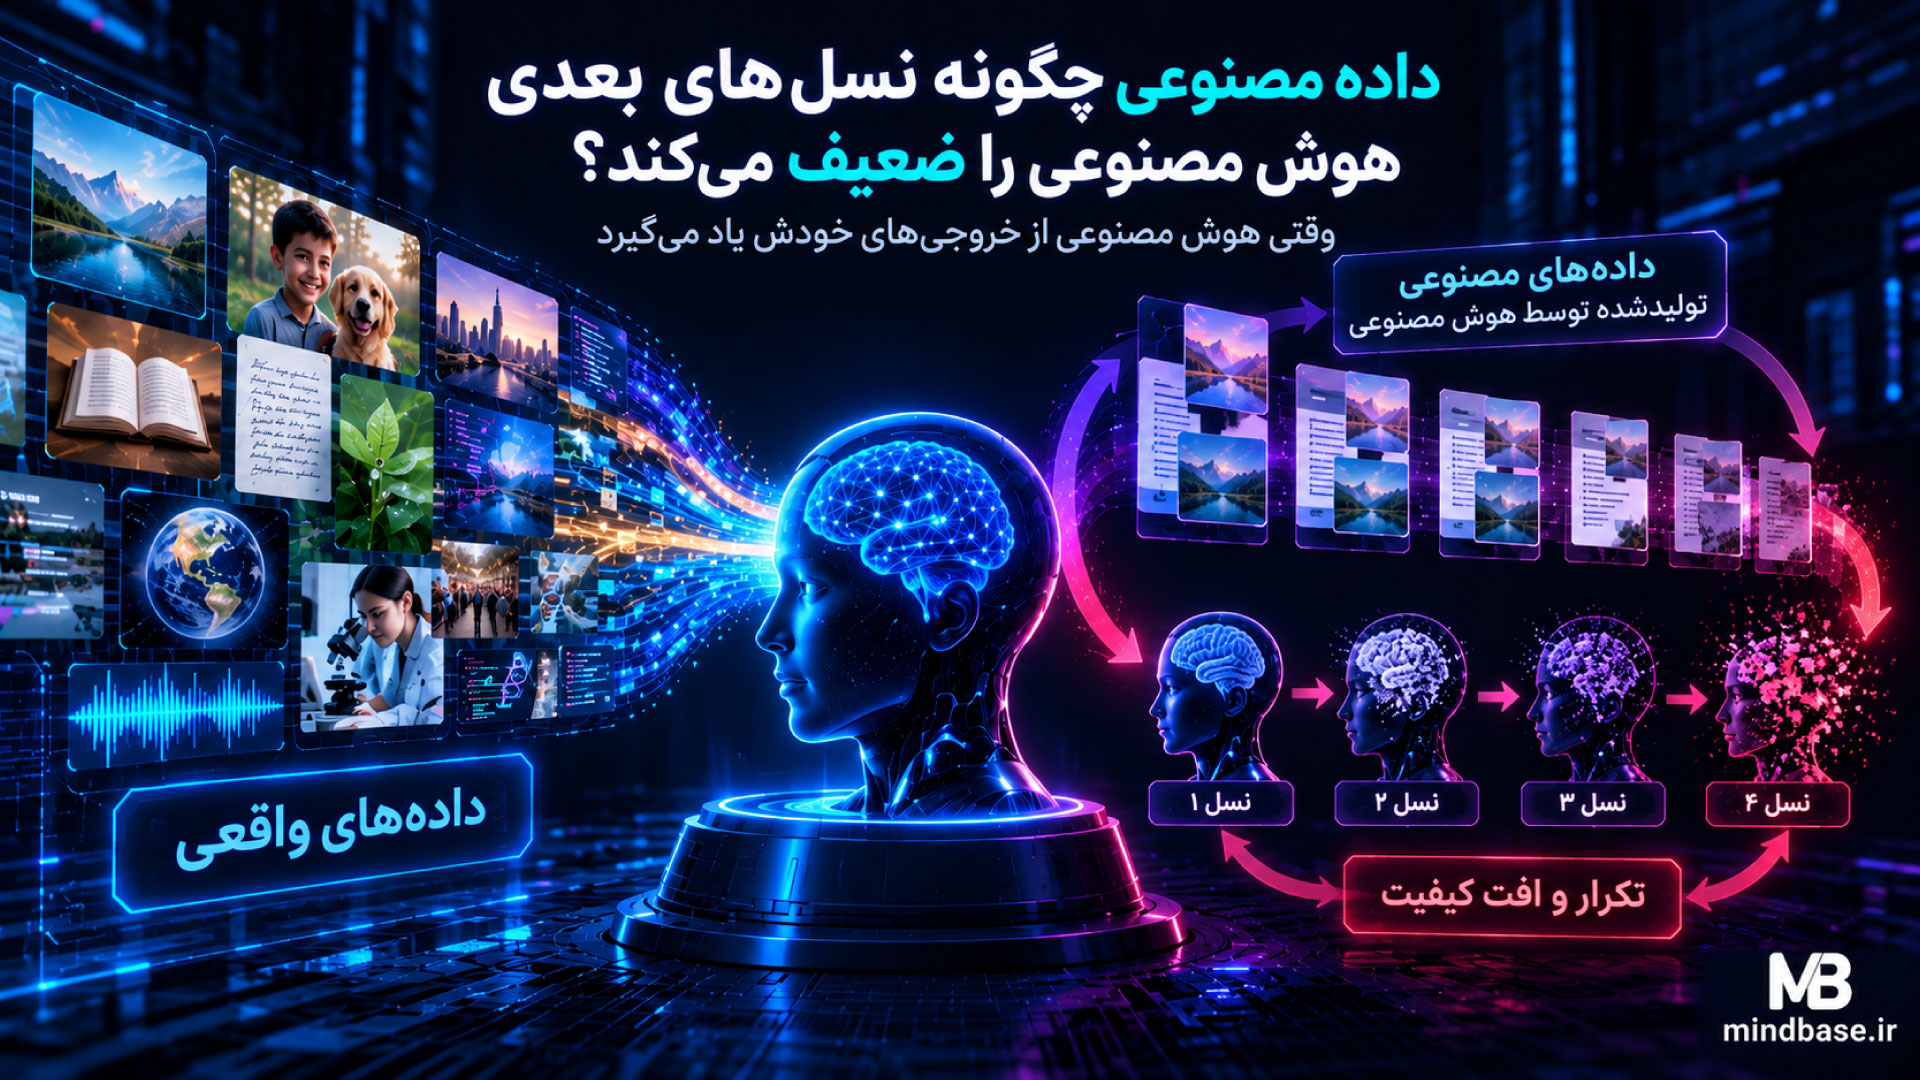
داده مصنوعی چگونه ممکن است نسلهای بعدی هوش مصنوعی را ضعیف کند؟
داده مصنوعی چیست؟
داده مصنوعی به دادهای گفته میشود که به جای جمعآوری مستقیم از رویدادها یا نمونههای واقعی، بهصورت مصنوعی توسط یک الگوریتم یا مدل تولید شده است.
در حوزه هوش مصنوعی، این داده میتواند شامل موارد مختلفی باشد:
- متن
- سؤال و جواب
- کد
- تصاویر
- ویدئو
- داده صوتی
- مکالمات
- دادههای ساختاریافته
- دادههای آموزشی برای Agentها
- نمونههای حل مسئله
- دادههای ترجیحی برای آموزش مدل
برای مثال فرض کنید میخواهیم یک مدل را برای پاسخگویی بهتر به سؤالات برنامهنویسی آموزش دهیم.
به جای اینکه میلیونها سؤال و جواب را انسانها بنویسند، میتوانیم از یک مدل قدرتمند بخواهیم:
«10 میلیون سؤال برنامهنویسی به همراه پاسخ و توضیح تولید کن.»
مدل میتواند این دادهها را در مدت بسیار کوتاهی تولید کند.
از نظر هزینه و سرعت، جذاب است.
و طبیعتاً بشر وقتی چیزی سریع و ارزان است، فوراً تصمیم میگیرد آن را در مقیاس چند میلیون برابر استفاده کند. تاریخ بشر پر از چنین تصمیمهای محتاطانهای است.
چرا صنعت هوش مصنوعی به داده مصنوعی نیاز پیدا کرده است؟
آموزش مدلهای بزرگ به حجم عظیمی از داده نیاز دارد.
در سالهای ابتدایی توسعه مدلهای زبانی، اینترنت منبع بسیار بزرگی از متن انسانی بود.
اما یک مشکل در حال جدیتر شدن است:
مدلها به داده بیشتری نیاز دارند، در حالی که داده انسانی باکیفیت محدود است.
از طرف دیگر، با گسترش مدلهای مولد، حجم محتوای تولیدشده توسط هوش مصنوعی در اینترنت نیز افزایش پیدا کرده است.
این یعنی بخشی از دادهای که مدلهای آینده هنگام جمعآوری اطلاعات از وب میبینند، ممکن است دیگر توسط انسان نوشته نشده باشد.
این مسئله یک چرخه بالقوه ایجاد میکند:
مدلهای فعلی
↓
تولید محتوای مصنوعی
↓
انتشار محتوا در اینترنت
↓
جمعآوری داده از اینترنت
↓
ورود محتوای مصنوعی به دیتاست آموزشی
↓
آموزش مدلهای آینده
↓
تولید محتوای مصنوعی بیشتر
و چرخه دوباره تکرار میشود.
پژوهش منتشرشده در Nature دقیقاً درباره چنین سناریویی هشدار داده و نشان داده است که آموزش مکرر مدلها روی داده تولیدشده توسط مدلهای قبلی میتواند به فرایندی به نام Model Collapse منجر شود.
Model Collapse چیست؟
Model Collapse یا فروپاشی مدل، به وضعیتی گفته میشود که در آن مدلهای مولد در اثر آموزش تکراری روی دادههای تولیدشده توسط مدلهای قبلی، به تدریج بخشی از تنوع و اطلاعات موجود در توزیع اصلی داده را از دست میدهند.
در پژوهش Nature، محققان نشان دادند که وقتی مدلها بهصورت بازگشتی روی خروجی مدلهای قبلی آموزش ببینند، بخشهایی از توزیع اصلی داده به مرور ناپدید میشود و رفتار مدل به سمت مجموعه محدودتری از الگوها حرکت میکند.
به زبان ساده:
مدل اول داده تولید میکند.
مدل دوم از آن داده یاد میگیرد.
مدل دوم نسخهای فشردهتر و ناقصتر از توزیع داده را یاد میگیرد.
مدل سوم از خروجی مدل دوم یاد میگیرد.
و بخشی از اطلاعاتی که مدل دوم هم از دست داده بود، دیگر وجود ندارد که به مدل سوم منتقل شود.
این اتفاق میتواند به مرور شدیدتر شود.
مشکل اصلی چیست؟
مشکل فقط این نیست که داده مصنوعی ممکن است «اشتباه» داشته باشد.
مشکل عمیقتر است.
مدلهای مولد معمولاً تلاش میکنند دادههایی تولید کنند که از نظر آماری محتمل باشند.
اما داده واقعی بسیار متنوعتر از خروجیهای رایج یک مدل است.
در داده انسانی میتوانیم با مواردی مثل:
- اشتباههای عجیب
- دیدگاههای نادر
- سبکهای نوشتاری متفاوت
- اصطلاحات غیرمعمول
- تجربههای شخصی
- زبان عامیانه
- نمونههای نادر
- ایدههای خلاقانه
- پاسخهای غیرمتعارف
روبرو شویم.
اما مدل ممکن است تمایل داشته باشد بیشتر به سمت الگوهایی برود که در دادههای آموزشی احتمال بالاتری دارند.
اگر همین خروجیها دوباره به عنوان داده آموزشی استفاده شوند، توزیع داده میتواند به سمت الگوهای رایجتر و محدودتر حرکت کند.
مشکل «دُم توزیع» چیست؟
در آمار و یادگیری ماشین، بخشهایی از توزیع داده که احتمال وقوع کمتری دارند، معمولاً به عنوان Tail یا دُم توزیع شناخته میشوند.
این نمونههای نادر ممکن است از نظر تعداد کم باشند، اما ارزش اطلاعاتی زیادی داشته باشند.
برای مثال در زبان انسانی، ممکن است یک عبارت بسیار نادر فقط توسط گروه کوچکی از افراد استفاده شود.
یا یک مسئله ریاضی خاص، یک سبک هنری خاص یا یک شکل غیرمعمول از استدلال تعداد نمونههای بسیار کمی داشته باشد.
اگر مدلهای بعدی بیشتر از دادههای مصنوعی رایج تغذیه شوند، این نمونههای نادر ممکن است کمتر و کمتر نمایندگی شوند.
پژوهش Nature درباره Model Collapse نیز به از بین رفتن تدریجی بخشهایی از توزیع اصلی و بهخصوص Tailهای توزیع اشاره میکند.
این یعنی ممکن است مدل ظاهراً همچنان عملکرد خوبی داشته باشد، اما بخشی از تنوع واقعی جهان را دیگر بهخوبی نمایش ندهد.
یک مثال ساده
فرض کنید یک مدل زبان را با 100 میلیون متن انسانی آموزش دادهایم.
در این مجموعه:
- 70٪ متنها سبک رایج دارند
- 20٪ سبکهای متفاوت دارند
- 9٪ سبکهای نسبتاً نادر دارند
- 1٪ نمونههای بسیار خاص و غیرمعمول هستند
حالا مدل از این مجموعه یاد میگیرد و خودش 100 میلیون متن تولید میکند.
ممکن است خروجی مدل دیگر دقیقاً همان توزیع را نداشته باشد.
مثلاً:
- 85٪ متنهای تولیدشده شبیه سبک رایج باشند
- 12٪ متفاوت باشند
- 3٪ نادر باشند
- نمونههای بسیار خاص تقریباً حذف شوند
اگر مدل بعدی بیشتر روی این مجموعه آموزش ببیند، ممکن است تنوع باز هم کاهش پیدا کند.
نسل بعدی دوباره داده تولید میکند.
و همین روند ادامه پیدا میکند.
در نهایت مدل ممکن است بسیار خوب به نظر برسد، اما دامنه رفتارها و اطلاعاتی که میتواند تولید کند محدودتر شده باشد.
چرا اشتباههای مدل هم خطرناک هستند؟
مدلهای هوش مصنوعی همیشه درست جواب نمیدهند.
ممکن است:
- اطلاعات نادرست تولید کنند
- منابع جعلی بسازند
- کد اشتباه بنویسند
- استدلال ناقص ارائه دهند
- محاسبات اشتباه انجام دهند
- سوگیری داشته باشند
- واقعیت را بیش از حد ساده کنند
اگر این خروجی بدون بررسی وارد دیتاست آموزشی نسل بعد شود، خطا میتواند منتقل شود.
حالا تصور کنید مدل دوم همان خطا را دوباره تولید کند.
مدل سوم روی خروجی مدل دوم آموزش میبیند.
خطا دوباره وارد چرخه میشود.
این همان چیزی است که مسئله را خطرناک میکند:
خطا فقط تولید نمیشود، بلکه میتواند بازتولید شود.
آیا خطاها در هر نسل بزرگتر میشوند؟
لزوماً هر خطای مشخصی بهصورت خطی بزرگتر نمیشود.
موضوع اصلی این است که در یک چرخه بازخورد، مدل میتواند بخشی از اطلاعات واقعی را از دست بدهد و توزیع داده به سمت خروجیهای محدودتر حرکت کند.
بنابراین Model Collapse را نباید فقط «کپی شدن اشتباهات» دانست.
این پدیده عمیقتر از آن است.
مسئله ترکیبی از:
از دست رفتن تنوع
تغییر توزیع داده
انتقال خطا
تقویت برخی الگوها
است.
آیا داده مصنوعی همیشه باعث Model Collapse میشود؟
خیر.
این نکته بسیار مهم است.
پژوهشها نشان دادهاند که نتیجه به نحوه استفاده از داده مصنوعی بستگی دارد.
یک پژوهش نمایهشده در Hugging Face با عنوان Is Model Collapse Inevitable? نشان میدهد که وقتی دادههای مصنوعی در کنار دادههای واقعی انباشته شوند، نه اینکه جایگزین آنها شوند، میتوان از فروپاشی مدل جلوگیری کرد.
پس مسئله این نیست:
Synthetic Data = Bad
بلکه بیشتر شبیه این است:
Uncontrolled Synthetic Data Feedback Loop = خطرناک
داده مصنوعی چه زمانی مفید است؟
داده مصنوعی میتواند بسیار ارزشمند باشد.
مثلاً برای تولید:
- نمونههای آموزشی تخصصی
- مسائل ریاضی
- دادههای برنامهنویسی
- سناریوهای نادر
- مکالمات آموزشی
- دادههای تست
- نمونههای چندزبانه
- داده برای Agentها
- دادههای ترجیحی
- داده برای Fine-tuning
استفاده از داده مصنوعی میتواند هزینه جمعآوری داده انسانی را کاهش دهد و امکان ساخت دیتاستهایی را فراهم کند که جمعآوری آنها در دنیای واقعی بسیار دشوار است.
بنابراین هدف حذف Synthetic Data نیست.
هدف، استفاده کنترلشده از آن است.
داده مصنوعی خوب چه ویژگیای دارد؟
داده مصنوعی خوب لزوماً دادهای نیست که فقط «زیاد» باشد.
کیفیت مهمتر از حجم خام است.
یک دیتاست مصنوعی خوب میتواند ویژگیهایی مثل این داشته باشد:
- تنوع بالا
- خطای کم
- پوشش مناسب موضوعات
- کنترل کیفیت
- اعتبارسنجی
- تنوع سبک
- عدم تکرار بیش از حد
- ترکیب با داده واقعی
- حذف نمونههای ضعیف
- بررسی سوگیری
به همین دلیل تولید 100 میلیون نمونه مصنوعی لزوماً بهتر از تولید 10 میلیون نمونه باکیفیت نیست.
مدل هم مثل انسان است، فقط با حافظه بیشتر و حقوق کمتر. اگر غذای بیکیفیت جلویش بگذارید، تعداد بشقابها مشکل را حل نمیکند.
Synthetic Data و Distillation چه ارتباطی دارند؟
یکی از کاربردهای مهم داده مصنوعی، Knowledge Distillation است.
در این روش یک مدل بزرگتر یا قدرتمندتر میتواند خروجیهایی تولید کند که برای آموزش مدل کوچکتر استفاده شوند.
مثلاً:
Teacher Model
↓
تولید داده و پاسخ
↓
Student Model
↓
آموزش
این روش میتواند بسیار مفید باشد.
اما کیفیت Teacher اهمیت زیادی دارد.
اگر دادههای تولیدشده ضعیف باشند یا فقط بخش محدودی از توانایی Teacher را پوشش دهند، Student نیز همان محدودیتها را یاد میگیرد.
بنابراین Distillation هم به کیفیت داده و انتخاب نمونهها وابسته است.
آیا مدل میتواند از خودش بهتر شود؟
این یکی از جذابترین ایدههای هوش مصنوعی است.
فرض کنید مدل:
- یک مسئله را حل کند.
- پاسخ خودش را بررسی کند.
- اشتباهات را پیدا کند.
- پاسخ بهتر تولید کند.
- از این داده برای آموزش استفاده شود.
در شرایط مناسب، چنین فرایندهایی میتوانند به بهبود مدل کمک کنند.
اما مشکل زمانی ایجاد میشود که سیستم نتواند به شکل مستقل و قابل اعتماد کیفیت داده تولیدشده را ارزیابی کند.
اگر:
Model A
خروجی تولید کند و
Model B
فقط براساس همان خروجیها تصمیم بگیرد چه چیزی درست است،
ممکن است خطاها در یک حلقه بسته تقویت شوند.
اهمیت Verification در داده مصنوعی
یکی از راههای مهم برای جلوگیری از این مشکل، استفاده از یک سیستم اعتبارسنجی مستقل است.
یعنی داده مصنوعی مستقیماً وارد آموزش نشود.
بلکه ابتدا:
تولید
↓
بررسی
↓
فیلتر
↓
اعتبارسنجی
↓
انتخاب
↓
آموزش
انجام شود.
پژوهشهای جدید نمایهشده در Hugging Face نیز بررسی کردهاند که استفاده از یک Verifier خارجی، شامل انسان یا مدل قویتر، چگونه میتواند به جلوگیری از Model Collapse کمک کند. البته این مطالعات همچنین نشان میدهند که خود Verifier نیز محدودیت دارد و اگر کاملاً قابل اعتماد نباشد، بهبود ممکن است در نهایت متوقف یا معکوس شود.
آیا انسان باید در چرخه باقی بماند؟
احتمالاً برای برخی کاربردهای حساس، بله.
Human-in-the-loop میتواند برای بررسی دادههای مصنوعی بسیار ارزشمند باشد.
مثلاً انسان میتواند نمونههایی را بررسی کند که مدل درباره کیفیت آنها مطمئن نیست.
اما استفاده از انسان برای بررسی تکتک میلیونها نمونه عملی نیست.
به همین دلیل سیستمهای واقعی معمولاً به سمت ترکیبی از:
- بررسی خودکار
- مدل ارزیاب
- قوانین کیفیت
- نمونهبرداری انسانی
- داده واقعی
- Deduplication
- فیلتر محتوایی
میروند.
چرا داده واقعی همچنان ارزشمند است؟
داده واقعی حاصل تعامل واقعی انسانها با جهان است.
در آن چیزهایی وجود دارد که ممکن است مدلها بهراحتی نتوانند خودشان تولید کنند:
- تجربه واقعی
- رفتارهای غیرقابل پیشبینی
- اشتباههای طبیعی
- تفاوتهای فرهنگی
- زبان روزمره
- نوآوری
- نمونههای نادر
- اطلاعات جدید
- اتفاقات واقعی
هرچه محتوای مصنوعی بیشتر شود، داده واقعی و باکیفیت میتواند ارزش بیشتری پیدا کند.
این نکته در پژوهش Nature نیز مطرح شده است: با افزایش محتوای تولیدشده توسط مدلها در وب، ارزش دادههایی که از تعاملات واقعی انسانها به دست میآیند بیشتر میشود.
اینترنت ممکن است تبدیل به یک حلقه بازخورد شود
تصور کنید در آینده بخش بزرگی از اینترنت توسط AI تولید شود.
مقالات توسط AI نوشته شوند.
تصاویر توسط AI ساخته شوند.
کد توسط AI تولید شود.
نظرات توسط AI نوشته شوند.
مستندات توسط AI تولید شوند.
سپس شرکتها دادههای اینترنت را جمعآوری کنند.
بدون تشخیص منشأ داده، بخشی از این محتوا وارد دیتاست آموزش مدل جدید شود.
مدل جدید نیز دوباره محتوا تولید کند.
این چرخه میتواند به یک مشکل بزرگ تبدیل شود:
AI → Internet → Dataset → AI
به همین دلیل تشخیص منشأ داده و کیفیت آن اهمیت بیشتری پیدا میکند.
مشکل فقط متن نیست
Model Collapse محدود به مدلهای زبانی نیست.
پژوهش Nature نشان داده است که پدیدههای مشابه در مدلهای مختلف مولد نیز قابل مشاهده هستند و در مطالعه اصلی، نمونههایی در LLMها، Variational Autoencoderها و Gaussian Mixture Modelها بررسی شدهاند.
پژوهشهای دیگری نیز این مسئله را در مدلهای تصویری و مدلهای مولد مختلف بررسی کردهاند.
بنابراین مسئله کلیتر از «متن تولیدشده توسط ChatGPT» است.
موضوع درباره یک چرخه عمومی است:
مدل داده تولید میکند
و
مدلهای بعدی از همان داده یاد میگیرند.
Model Autophagy چیست؟
در برخی پژوهشها از اصطلاحهایی مانند Model Autophagy Disorder یا خودخواری مدل برای توصیف چرخهای استفاده شده که در آن مدلها به طور فزاینده از دادههای مصنوعی خودشان تغذیه میکنند.
ایده ساده است:
مدل از خروجی خودش تغذیه میکند.
سپس خروجی جدید تولید میکند.
نسل بعد دوباره از این خروجی استفاده میکند.
پژوهشهای مربوط به Self-Improving Diffusion Models نیز این خطر را بررسی کردهاند و توضیح دادهاند که استفاده مکرر از دادههای تولیدشده توسط مدلهای قبلی میتواند کیفیت و تنوع داده را کاهش دهد.
آیا مدلهای آینده واقعاً ممکن است ضعیف شوند؟
این احتمال جدی است، اما نباید آن را به شکل یک پیشبینی قطعی بیان کرد.
مسئله به نحوه ساخت دیتاستهای آینده بستگی دارد.
اگر داده واقعی همچنان بخش مهمی از آموزش باشد و داده مصنوعی به شکل کنترلشده استفاده شود، خطر کاهش مییابد.
اما اگر داده مصنوعی به شکل گسترده جایگزین داده واقعی شود و مدلها بارها روی خروجی نسلهای قبلی آموزش ببینند، خطر Model Collapse جدیتر میشود.
بنابراین آینده احتمالاً نه «بدون داده مصنوعی» خواهد بود و نه «کاملاً مصنوعی».
بلکه ترکیبی از منابع مختلف داده خواهد بود.
راههای جلوگیری از Model Collapse
چند راهکار اصلی برای کاهش این خطر وجود دارد.
1. حفظ داده واقعی
مهمترین راهکار این است که داده مصنوعی جایگزین کامل داده واقعی نشود.
داده واقعی باید همچنان بخش مهمی از دیتاست را تشکیل دهد.
2. ترکیب داده واقعی و مصنوعی
به جای اینکه دیتاست نسل جدید فقط از خروجی مدل قبلی ساخته شود، دادههای واقعی و مصنوعی میتوانند با هم استفاده شوند.
پژوهشهای موجود نشان دادهاند که انباشتن داده مصنوعی در کنار داده واقعی میتواند از سناریوی فروپاشی ناشی از جایگزینی کامل جلوگیری کند.
3. اعتبارسنجی داده مصنوعی
هر داده مصنوعی نباید فقط به این دلیل که توسط یک مدل بزرگ تولید شده، معتبر فرض شود.
باید کیفیت آن بررسی شود.
4. استفاده از Verifier
یک مدل یا سیستم مستقل میتواند داده تولیدشده را بررسی کند.
در برخی پژوهشهای جدید، استفاده از Verifier خارجی برای جلوگیری از فروپاشی بررسی شده است.
5. حفظ تنوع
اگر تمام دادههای مصنوعی بیش از حد شبیه هم باشند، مدل نسل بعد نیز تنوع کمتری یاد میگیرد.
بنابراین باید تنوع:
- موضوع
- سبک
- زبان
- استدلال
- سطح دشواری
- دیدگاه
حفظ شود.
6. حذف دادههای تکراری
اگر میلیونها نمونه تقریباً مشابه تولید شوند، تعداد زیاد آنها به معنی اطلاعات زیاد نیست.
Deduplication میتواند جلوی این مشکل را بگیرد.
7. تشخیص محتوای مصنوعی
در بعضی خطوط تولید داده، تشخیص اینکه یک نمونه توسط انسان تولید شده یا مدل میتواند برای مدیریت دیتاست مفید باشد.
البته تشخیص AI-generated بودن همیشه ساده و قطعی نیست.
8. نگه داشتن نسخههای اصلی داده
به جای اینکه دادههای واقعی پس از پردازش از بین بروند، بهتر است مجموعههای اصلی و باکیفیت حفظ شوند.
این کار امکان مقایسه نسلهای مختلف داده و مدل را فراهم میکند.
آیا Synthetic Data میتواند حتی بهتر از داده واقعی باشد؟
بله، در بعضی کاربردها.
مثلاً اگر بخواهیم یک مدل را برای یک مهارت بسیار خاص آموزش دهیم، ساخت داده مصنوعی هدفمند میتواند بسیار مؤثر باشد.
فرض کنید مدل باید یاد بگیرد چگونه یک API خاص را فراخوانی کند.
میتوان هزاران سناریوی مختلف تولید کرد:
- درخواست موفق
- درخواست ناموفق
- ورودی ناقص
- خطای احراز هویت
- خطای سرور
- داده نامعتبر
- چند ابزار همزمان
تولید چنین سناریوهایی با داده واقعی ممکن است بسیار پرهزینه باشد.
Synthetic Data در اینجا یک مزیت واقعی دارد.
مشکل زمانی ایجاد میشود که تصور کنیم:
هرچه داده مصنوعی بیشتر، مدل بهتر.
چنین رابطه سادهای وجود ندارد.
داده مصنوعی و آینده AI
احتمالاً داده مصنوعی بخش مهمی از آینده آموزش مدلها خواهد بود.
مدلهای آینده احتمالاً از ترکیبی از:
داده انسانی
داده مصنوعی
دادههای تأییدشده
دادههای تخصصی
دادههای تولیدشده در محیطهای شبیهسازیشده
استفاده خواهند کرد.
اما هرچه سهم Synthetic Data افزایش پیدا کند، مدیریت کیفیت آن نیز مهمتر خواهد شد.
مسئله آینده فقط این نیست که:
چقدر داده داریم؟
بلکه این است:
این داده از کجا آمده است؟
چه کسی یا چه چیزی آن را تولید کرده؟
آیا معتبر است؟
آیا نمونه مشابه آن قبلاً در دیتاست وجود دارد؟
آیا داده واقعی پشت آن وجود دارد؟
آیا مدل قبلی این داده را تولید کرده است؟
این پرسشها احتمالاً بخش مهمی از مهندسی داده برای نسلهای بعدی AI خواهند بود.
آیا Model Collapse قابل جلوگیری است؟
شواهد موجود نشان میدهند که در بسیاری از شرایط میتوان خطر آن را کاهش داد.
پژوهشهایی که در Hugging Face نمایه شدهاند، روشهایی مانند حفظ و انباشت داده واقعی، اعتبارسنجی داده مصنوعی و انتخاب هدفمند داده را بررسی کردهاند. همچنین پژوهشهای جدیدتر به روشهایی برای جلوگیری یا کاهش Collapse از طریق Verification و Curation پرداختهاند.
بنابراین سناریوی محتمل آینده این نیست که:
«داده مصنوعی مدلها را نابود میکند.»
بلکه مسئله این است:
«اگر داده مصنوعی بدون مدیریت کیفیت و بدون حفظ تنوع داده واقعی وارد چرخه آموزش شود، میتواند کیفیت و تنوع نسلهای بعدی مدلها را کاهش دهد.»
این تفاوت مهم است.
یک چرخه سالم برای آموزش مدلهای آینده
یک معماری منطقی میتواند چیزی شبیه این باشد:
داده واقعی
↓
پاکسازی و کنترل کیفیت
↓
آموزش مدل
↓
تولید داده مصنوعی
↓
اعتبارسنجی و فیلتر
↓
ترکیب با داده واقعی
↓
آموزش نسل بعدی
↓
ارزیابی
↓
تکرار
در این مدل، Synthetic Data یک جایگزین کامل برای واقعیت نیست.
بلکه ابزاری برای افزایش داده، ایجاد سناریوهای جدید و هدفمند کردن آموزش است.
بزرگترین خطر چیست؟
شاید بزرگترین خطر این نباشد که مدلهای آینده ناگهان «احمق» شوند.
مشکل میتواند بسیار ظریفتر باشد.
مدل ممکن است همچنان:
- سریع باشد
- روان صحبت کند
- کد تولید کند
- آزمونهای استاندارد را خوب پاس کند
- پاسخهای بسیار حرفهای ارائه دهد
اما در عین حال:
تنوع کمتری داشته باشد.
دیدگاههای کمتری را پوشش دهد.
نمونههای نادر را ضعیفتر درک کند.
سوگیریهای موجود را تقویت کند.
و بخشی از توزیع واقعی داده را از دست داده باشد.
برخی پژوهشهای جدید حتی موضوع را از نظر Fairness بررسی کردهاند و گزارش دادهاند که آموزش تکراری روی داده مصنوعی میتواند برخی سوگیریهای جمعیتی را تشدید کند، حتی پیش از آنکه افت عملکرد عمومی بهوضوح در معیارهای استاندارد دیده شود. این حوزه هنوز در حال تحقیق است و نباید آن را بهعنوان یک قانون قطعی برای همه مدلها در نظر گرفت.
جمعبندی
داده مصنوعی یکی از قدرتمندترین ابزارهای توسعه هوش مصنوعی است، اما همان ابزاری که میتواند مشکل کمبود داده را حل کند، اگر بدون کنترل استفاده شود، میتواند مشکل جدیدی ایجاد کند.
وقتی یک مدل از داده انسانی یاد میگیرد، سپس داده تولید میکند و مدل بعدی روی همان داده مصنوعی آموزش میبیند، یک چرخه بازخورد ایجاد میشود.
اگر در این چرخه داده واقعی به تدریج حذف شود، ممکن است:
- تنوع داده کاهش پیدا کند
- نمونههای نادر از بین بروند
- توزیع داده تغییر کند
- خطاها منتقل شوند
- سوگیریها تقویت شوند
- عملکرد نسلهای بعدی کاهش پیدا کند
این پدیده با عنوان Model Collapse شناخته میشود و در پژوهشهای مختلف بهصورت نظری و تجربی بررسی شده است.
اما نتیجه این نیست که باید Synthetic Data را کنار گذاشت.
داده مصنوعی میتواند برای آموزش مدلهای آینده بسیار ارزشمند باشد، به شرطی که:
داده واقعی حفظ شود
داده مصنوعی با داده واقعی ترکیب شود
نمونهها اعتبارسنجی شوند
تنوع حفظ شود
دادههای تکراری حذف شوند
منشأ داده مشخص باشد
و در صورت امکان، یک سیستم مستقل برای ارزیابی کیفیت داده وجود داشته باشد.
در نهایت، مسئله آینده هوش مصنوعی فقط «کمبود داده» نیست.
ممکن است مشکل بزرگتر این باشد که چه بخشی از دادهای که در اختیار داریم واقعاً از جهان واقعی آمده است.
اگر مدلهای آینده قرار باشد از خروجی مدلهای قبلی یاد بگیرند، باید مطمئن شویم که این چرخه تبدیل به یک اتاق پژواک عظیم نشود که در آن AI به AI آموزش میدهد و در نهایت همه به یک چیز مشابه فکر میکنند. طبیعتاً ساختن چنین چرخهای برای انسانها بسیار محتمل است، چون ما در ساختن سیستمهای پیچیدهای که بعداً خودمان مجبور به مدیریتشان میشویم، سابقه درخشانی داریم.