
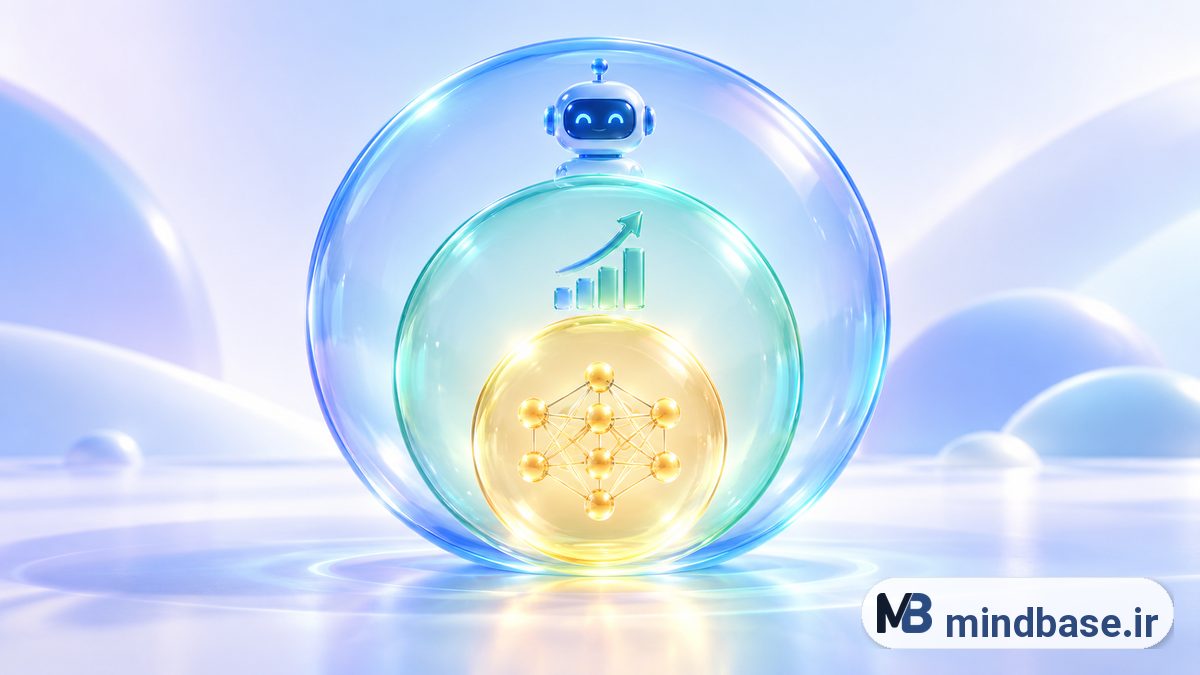
در اخبار و آگهیها این سه واژه تقریباً بهجای هم به کار میروند: یک شرکت «هوش مصنوعی» معرفی میکند، محصولش «یادگیری ماشین» دارد و موتورش «یادگیری عمیق» است. اما این سه یکی نیستند؛ سه دایرهی تودرتو هستند که هر کدام سؤال متفاوتی را جواب میدهند و مرزشان در عمل مهم است: وقتی میدانید هر کدام چه میکند، میتوانید برای مسئلهی خودتان ابزار درست را انتخاب کنید و ادعای ابزارها را هم درست بخوانید. در این مطلب هر سه را با یک مثال واحد پیش میبریم تا تفاوتها مشخص شود، نه در تعریفهای انتزاعی، بلکه در کاری که عملاً انجام میدهند.
رابطهی سه دایرهی تودرتو
رابطهی این سه، رابطهی «زیرمجموعه» است:
- هوش مصنوعی دایرهی بزرگ است: هر تلاشی برای ساختن سیستمی که کاری نیازمند هوش انجام دهد.
- یادگیری ماشین دایرهی داخل آن است: روشی خاص برای ساختن هوش مصنوعی، از راه یادگیری از داده.
- یادگیری عمیق دایرهی داخل یادگیری ماشین است: نوع خاصی از یادگیری ماشین با شبکههای عصبی چندلایه.
پس هر یادگیری عمیق، یادگیری ماشین است؛ و هر یادگیری ماشین، هوش مصنوعی است. اما برعکسش برقرار نیست: هوش مصنوعی لزوماً یادگیری ماشین ندارد و یادگیری ماشین لزوماً عمیق نیست. این جمله کوتاه، بیشترِ اشتباههای رایج را حل میکند.
هوش مصنوعی «هدف» است، یادگیری ماشین «یک روش» برای رسیدن به آن هدف است، و یادگیری عمیق «یک نوع خاص» از آن روش.
هوش مصنوعی: هدف، نه تکنیک
هوش مصنوعی از سال ۱۹۵۶ بهعنوان یک رشته تعریف شد: ساختن ماشینهایی که کارهایی را انجام دهند که اگر انسان انجام میداد، به آن میگفتیم هوش. این تعریف عمداً بزرگ است، چون «هدف» را مشخص میکند نه «روش» را. سیستمهای هوش مصنوعی قدیمی معمولاً با قاعده ساخته میشدند: کارشناسها مینشستند و هزاران «اگر-آنگاه» مینوشتند؛ سیستمهای تشخیص بیماری دههی هشتاد، رباتهای گفتگوی اولیه و موتورهای بازی شطرنج غیرعصبی همه از این جنس بودند.
نقطهی ضعف این روش هم همانجا بود که به مقیاس میرسید: قواعد برای دنیای تمیز جواب میدهند، نه برای دنیایی که در آن یک ایمیل هزار شکل فریب دارد و یک عکس هزار نور و زاویه. به همین دلیل، بخش بزرگی از موفقیتهای اخیر از مسیر دیگری آمده: بهجای نوشتن قاعده، یادگرفتن از نمونه.
یادگیری ماشین: بهجای قاعدهنویسی، نمونهبینی
ایدهی یادگیری ماشین یک چرخش ساده اما تعیینکننده است: بهجای اینکه انسان قواعد را بنویسد، انسان مثالها را میدهد و ماشین الگو را پیدا میکند. در برنامهنویسی کلاسیک، ورودی و قواعد را میدهید و خروجی میگیرید؛ در یادگیری ماشین، ورودی و خروجیهای نمونه را میدهید و قواعد را میگیرید — بهشکل مدلی که برای نمونههای دیدهنشده هم کار کند.
مثال همیشهسبز، فیلتر هرزنامه است. با قاعدهنویسی مینویسید «اگر کلمهی برنده بودن باشد، هرز است»؛ بعد از هفتهی اول، ارسالکنندهها میفهمند و به «بــرنــدۀ» تبدیلش میکنند و قاعدهتان شکست خورده. با یادگیری ماشین، هزاران ایمیل با برچسب «هرز» و «سالم» به مدل میدهید و مدل خودش یاد میگیرد دهها نشانهی ظریف را با هم ترکیب کند؛ وقتی شکل حمله عوض شود، با نمونههای تازه دوباره آموزش میبینید و مدل بهروز میشود.
یادگیری ماشین «کلاسیک» — الگوریتمهایی مثل درخت تصمیم، جنگل تصادفی و رگرسیون — هنوز هم ابزار انتخاب برای دادههای جدولی و حجمهای متوسط است؛ و این یکی از دلایل مهم است که «یادگیری عمیق» را برای هر مسئلهای انتخاب نمیکنیم.
یادگیری عمیق: شبکههای عصبی چندلایه
یادگیری عمیق نوع خاصی از یادگیری ماشین است که مدلِ یادگیرنده، شبکهی عصبی با لایههای متعدد است — واژهی «عمیق» یعنی همین تعداد لایهها. ایدهی شبکهی عصبی از نورونهای مغز الهام گرفته شده، اما آنچه مهم است ریاضیات سادهی آن است: هر لایه، ورودی قبلی را بهشکلی ترکیب و تبدیل میکند و لایهی بعدی روی خروجی آن کار میکند.
قدرت این ساختار در «یادگیری نمایهها»ست: در تشخیص تصویر، لایههای اول لبهها و خطها را یاد میگیرند، لایههای میانی ترکیبهایی مثل چشم و گوش، و لایههای آخر مفاهیم کامل مثل «گربه» را. انسان هیچکدام از اینها را به مدل نگفته؛ از دل نمونهها بیرون آمده است. همین ساختار بود که حدود سال ۲۰۱۲ با رسیدن داده و پردازندهی گرافیکی کافی، جهش بزرگ کیفیت تشخیص تصویر و گفتار را ساخت و زیربنای همهی مدلهای زبانی امروزی — از جمله مدلهایی که در مطلب مدل زبانی چیست بررسی میکنیم — شد.
بهای این قدرت هم مشخص است: یادگیری عمیق دادهی بسیار بیشتر و محاسبهی سنگینتر میخواهد و مدل نهایی نسبت به یادگیری ماشین کلاسیک کمتر قابل تفسیر است. برای مسائلی با دادهی کم یا نیاز به توضیحپذیری، گزینهی سادهتر اغلب انتخاب بهتری است.
یک مسئله، سه راهحل
برای دیدن تفاوت در عمل، یک مسئلهی واحد را با هر سه روش ببینیم: تشخیص فاکتورهای جعلی در یک کسبوکار.
- با قاعدهنویسی (هوش مصنوعی کلاسیک): کارشناس مالی میگوید فاکتور بالای سقف معمول و خارج ساعت اداری مشکوک است. سیستم شفاف و قابل توضیح است، اما تقلبکننده فقط کافی است زیر سقف فاکتور بزند تا از آن عبور کند.
- با یادگیری ماشین کلاسیک: فاکتورهای پنج سال گذشته با برچسب «معتبر» و «جعلی» به الگوریتمی مثل جنگل تصادفی داده میشود، همراه ویژگیهایی که تیم شما برایش تعریف کرده (مبلغ، ساعت، شهر، سابقهی فروشنده). مدل الگوهای ترکیبی را پیدا میکند و در دادههای جدولی معمولاً بهترین نسبت دقت به هزینه را میدهد.
- با یادگیری عمیق: تصویر فاکتور خام به مدل داده میشود، بدون هیچ ویژگی دستساز. مدل خودش از پیکسلها تا الگوی مهر و امضا و ساختار جدول را یاد میگیرد. برای شکلهای جدید تقلب مقاومتر است، اما به هزاران نمونه و پردازش سنگین نیاز دارد و توضیح اینکه «چرا جعلی دانست» سختتر است.
هیچکدام «بهترین» مطلق نیست؛ انتخاب به داده، هزینه و نیاز به توضیحپذیری بستگی دارد. این همان جایی است که دانستن مرز این سه مفهوم از حوصلهی terminology خارج میشود و تصمیم فنی میسازد.
مدلهای زبانی کجای این نقشهاند؟
مدلهای زبانی بزرگ مثل ChatGPT، Claude و Gemini در دایرهی داخلیاند: یادگیری عمیق خالص. معماری ترنسفورمر، آموزش روی حجم عظیمی از متن، و مقیاس میلیاردها پارامترشان همه از جنس یادگیری عمیق است. به همین دلیل همهی ویژگیهای این دایره را هم به ارث بردهاند: نیاز به داده و محاسبهی عظیم، قدرت شگفتانگیز در کارهای پیچیده، و ضعف در توضیحپذیری و در پاسخهای قطعی. اگر میخواهید بدانید این مدلها چطور از متنِ خام به این توانایی رسیدهاند، مسیر پیشنهادی ما این است: اول مدل زبانی چیست، بعد توکن چیست و پنجرهی زمینه.
جمعبندی
دفعهی بعد که ابزاری خودش را «هوش مصنوعی» معرفی کرد، این سه سؤال را بپرسید: زیر همین برچسب چه روشی کار میکند؟ اگر یادگیری ماشین است، چه نوعی؟ و اگر یادگیری عمیق است، آیا مسئلهی شما واقعاً به دادهی زیاد و مدل بزرگ نیاز دارد یا چند صد نمونه با یک مدل ساده همان جواب را ارزانتر میدهد؟ این سه سؤال، ادعای بازاریابی را به تصمیم فنی تبدیل میکند — و اگر پاسخها به سمت مدلهای زبانی بزرگ رفت، مایندبیس همین مسیر را برایتان ساده کرده است: با حساب رایگان شروع کنید و همین مفاهیم را با کار واقعی بسنجید.