بلاگ

مقالات و مطالب آموزشی

Function Calling چیست؟ وقتی مدل به‌جای حرف، ابزار صدا می‌زند

Function Calling چیست؟ وقتی مدل به‌جای حرف، ابزار صدا می‌زند

مدل زبانی به داده‌ی زنده و سیستم شما دسترسی ندارد؛ اما می‌تواند «برگه‌ی درخواست» بنویسد. در این مطلب می‌بینیم Function Calling چگونه کار می‌کند، چرا خروجی ساختاریافته این‌قدر مهم است و چه نسبتی با MCP و عامل‌ها دارد.
System Prompt چیست؟ نقش دستور سیستمی و تفاوتش با پیام کاربر

System Prompt چیست؟ نقش دستور سیستمی و تفاوتش با پیام کاربر

مدل در هر گفتگو دو نوع دستور می‌گیرد: یک متن ثابت که شما ننوشته‌اید و پیام‌هایی که شما می‌نویسید. در این مطلب می‌بینیم System Prompt چیست، چرا وزنش از پیام کاربر بیشتر است و چطور برای کارهای جدی دستور سیستمی بنویسیم.

Temperature چیست؟ پیچ تنظیم تصادف و خلاقیت مدل

Temperature چیست؟ پیچ تنظیم تصادف و خلاقیت مدل

هر بار یک سؤال را تکرار می‌کنید، جواب متفاوتی می‌گیرید؛ این تصادف عمدی است و Temperature پیچ تنظیم آن. در این مطلب می‌بینیم مدل چطور بین گزینه‌ها انتخاب می‌کند، این پارامتر چه می‌کند و کجا باید بالا یا پایینش ببرید.

عامل هوش مصنوعی (AI Agent) چیست و چه فرقی با چت‌بات دارد؟

عامل هوش مصنوعی (AI Agent) چیست و چه فرقی با چت‌بات دارد؟

چت‌بات به سؤال جواب می‌دهد؛ عامل کار را انجام می‌دهد. در این مطلب تفاوت این دو را دقیق می‌بینیم: عامل چیست، چه اجزایی دارد، چه کارهایی ازش برمی‌آید و کجا هنوز شکست می‌خورد.

پایگاه داده‌ی برداری چیست و چه زمانی لازم است؟

پایگاه داده‌ی برداری چیست و چه زمانی لازم است؟

وقتی میلیون‌ها امبدینگ دارید و باید «مشابه‌ترین‌ها» را در کسری از ثانیه پیدا کنید، جست‌وجوی معمولی جواب نمی‌دهد. در این مطلب پایگاه داده‌ی برداری را می‌بینیم: چگونه کار می‌کند، گزینه‌های اصلی و معیار انتخاب.

مدل انتشار (Diffusion) چیست و چطور تصویر می‌سازد؟

مدل انتشار (Diffusion) چیست و چطور تصویر می‌سازد؟

ابزارهایی مثل Midjourney از یک تصویرِ پوشیده از نویز شروع می‌کنند و گام‌به‌گام آن را به تصویر نهایی تبدیل می‌کنند. در این مطلب می‌بینیم مدل انتشار چطور کار می‌کند، متن چطور راهنمایش می‌شود و نقاط قوت و ضعفش چیست.

امبدینگ (Embedding) چیست و کجا به کار می‌آید؟

امبدینگ (Embedding) چیست و کجا به کار می‌آید؟

امبدینگ معنای متن را به فهرستی از اعداد تبدیل می‌کند تا ماشین بتواند «نزدیکی معنا» را بسنجد. در این مطلب می‌بینیم امبدینگ چطور کار می‌کند و چرا پایه‌ی جست‌وجوی معنایی و RAG است.

Fine-tuning چیست و چه زمانی لازم است؟

Fine-tuning چیست و چه زمانی لازم است؟

تنظیم دقیق مدل ابزار قدرتمندی است، اما اغلب جایی به کار می‌آید که فکر می‌کنیم لازم است و جایی که واقعاً لازم است، به آن فکر نمی‌کنیم. در این مطلب می‌بینیم Fine-tuning چه می‌کند، چه زمانی درست است و چه زمانی پرامپت و RAG کافی‌اند.

مدل زبانی بزرگ (LLM) چیست و چطور کار می‌کند؟

مدل زبانی بزرگ (LLM) چیست و چطور کار می‌کند؟

تمام قدرت ابزارهایی مثل ChatGPT از یک ایده‌ی ساده می‌آید: حدس زدن کلمه‌ی بعدی. در این مطلب می‌بینیم مدل زبانی دقیقاً چه می‌کند، «بزرگ» بودن آن چه چیزی اضافه می‌کند و یک پاسخ چطور از ورودی تا خروجی ساخته می‌شود.

LoRA چیست؟ سفارشی‌سازی مدل با کسری از هزینه

LoRA چیست؟ سفارشی‌سازی مدل با کسری از هزینه

آموزش کامل یک مدل بزرگ برای یک شرکت ممکن نیست؛ LoRA همین کار را با افزودن چند ماتریس کوچک به‌جای تغییر همه‌ی پارامترها ممکن کرده است. در این مطلب می‌بینیم LoRA چطور کار می‌کند و در عمل چه می‌دهد.

پروتکل MCP چیست و چرا آن را USB-C دنیای AI می‌نامند؟

پروتکل MCP چیست و چرا آن را USB-C دنیای AI می‌نامند؟

قبل از MCP، وصل‌کردن هر عامل به هر ابزار یک پروژه‌ی جداگانه بود. MCP این معادله را عوض کرده: یک بار ابزار را استاندارد بسازید، همه‌ی عامل‌های سازگار از آن استفاده کنند. در این مطلب می‌بینیم MCP چگونه کار می‌کند و چه چیزی را تغییر داده است.

معماری Mixture of Experts (MoE) چیست؟

معماری Mixture of Experts (MoE) چیست؟

چطور مدل‌هایی با تریلیون‌ها پارامتر با هزینه‌ی معقول اجرا می‌شوند؟ پاسخ MoE است: تقسیم مدل به متخصص‌ها و فعال‌سازی فقط چند تای مرتبط برای هر ورودی. در این مطلب این معماری را ساده و دقیق توضیح می‌دهیم.

مدل چندوجهی (Multimodal) چیست و چه کارهایی می‌کند؟

مدل چندوجهی (Multimodal) چیست و چه کارهایی می‌کند؟

مدل‌های اول فقط متن می‌فهمند؛ مدل‌های چندوجهی امروز عکس می‌بینند، صدا می‌شنوند و ویدیو تحلیل می‌کنند. در این مطلب می‌بینیم چندوجهی یعنی چه، پشت صحنه چطور کار می‌کند و در عمل چه کاربردی دارد.

تقطیر و کوانتیزاسیون چیست؟ سبک‌سازی مدل برای اجرای ارزان

تقطیر و کوانتیزاسیون چیست؟ سبک‌سازی مدل برای اجرای ارزان

چطور مدل‌های عظیم روی لپ‌تاپ و گوشی اجرا می‌شوند؟ دو تکنیک کلیدی: تقطیر که دانش مدل بزرگ را به مدل کوچک منتقل می‌کند و کوانتیزاسیون که اعداد مدل را فشرده می‌کند. در این مطلب هر دو را ساده و کاربردی می‌بینیم.

RAG چیست و چرا تقریباً هر محصول جدی AI از آن استفاده می‌کند؟

RAG چیست و چرا تقریباً هر محصول جدی AI از آن استفاده می‌کند؟

RAG به مدل اجازه می‌دهد قبل از پاسخ، اسناد واقعی سازمان شما را بخواند؛ نتیجه، پاسخ‌های مبتنی بر داده‌ی به‌روز به‌جای حافظه‌ی ایستا. در این مطلب می‌بینیم RAG چطور کار می‌کند و چرا این‌قدر پرکاربرد شده است.

مدل استدلالی (Reasoning Model) چیست و چه زمانی به کارش می‌آید؟

مدل استدلالی (Reasoning Model) چیست و چه زمانی به کارش می‌آید؟

مدل‌های استدلالی قبل از پاسخ، «فکر می‌کنند»؛ در مسائل سخت جهشی محسوس دارند اما کندتر و گران‌ترند. در این مطلب می‌بینیم این تفکر چطور کار می‌کند، چه معاوضه‌ای می‌سازد و کجا ارزشش را دارد.
مدل زبانی کوچک (SLM) چیست و چه زمانی به‌جای LLM بهتر است؟

مدل زبانی کوچک (SLM) چیست و چه زمانی به‌جای LLM بهتر است؟

همه‌چیز همیشه به مدل غول‌پیکر نیاز ندارد؛ مدل‌های زبانی کوچک روی لپ‌تاپ و گوشی اجرا می‌شوند، ارزان و سریع‌اند و برای کارهای محدود به‌اندازه‌ی مدل‌های بزرگ خوب‌اند. در این مطلب می‌بینیم SLM چیست و کجا انتخاب درست است.

توکن چیست و چرا همه‌چیز به آن وابسته است؟

توکن چیست و چرا همه‌چیز به آن وابسته است؟

قیمت API، سقف طول گفتگو و سرعت پاسخ همه به یک واحد کوچک وصل‌اند: توکن. در این مطلب می‌بینیم توکن چیست، چرا متن فارسی توکن بیشتری مصرف می‌کند و چطور مصرف را مدیریت کنید.

مدل زبانی چه می‌داند و چه نمی‌داند؟

مدل زبانی چه می‌داند و چه نمی‌داند؟

مدل زبانی تاریخ تاریخی را می‌داند اما آخرین اخبار را نه؛ شعر حفظ است اما قیمت امروز را نمی‌داند. در این مطلب مرز دقیق دانش مدل‌ها را می‌بینیم: چه چیزی داخل، چه چیزی بیرون و چطور با این مرز کار کنیم.

راهنمای انتخاب مدل هوش مصنوعی — کدام مدل برای کدام کار

راهنمای انتخاب مدل هوش مصنوعی — کدام مدل برای کدام کار

انتخاب مدل از میان ده‌ها گزینه سخت به نظر می‌رسد؛ اما با سه معیار — نوع کار، بودجه و الزام‌ها — به یک تصمیم ساده می‌رسد. در این مطلب روش انتخاب را می‌بینیم و برای کارهای رایج پیشنهاد مشخص می‌دهیم.

پرامپت‌نویسی به زبان فارسی — نکات و دام‌های کار با مدل‌ها

پرامپت‌نویسی به زبان فارسی — نکات و دام‌های کار با مدل‌ها

مدل‌ها با فارسی متفاوت رفتار می‌کنند: توکن‌بندی پرهزینه‌تر، خروجی RTL که به‌هم می‌ریزد و اعداد فارسی/انگلیسی. در این مطلب دام‌های واقعی کار با فارسی و راه‌حل‌های عملی هر کدام را می‌بینیم.

تکنیک‌های پرامپت‌نویسی — از نقش دادن تا زنجیره‌ی فکر

تکنیک‌های پرامپت‌نویسی — از نقش دادن تا زنجیره‌ی فکر

هشت تکنیک عملی پرامپت‌نویسی که تفاوت جواب معمولی و جواب حرفه‌ای را می‌سازند: نقش‌دهی، مثال‌زدن، خروجی ساختاریافته، زنجیره‌ی فکر و چرخه‌ی اصلاح. با مثال‌های قبل و بعد برای هر تکنیک.

ارزیابی کیفیت سیستم RAG — چطور بفهمیم درست جواب می‌دهد؟

ارزیابی کیفیت سیستم RAG — چطور بفهمیم درست جواب می‌دهد؟

RAG بدون ارزیابی، سیستم کور است. در این مطلب دو سطح ارزیابی — بازیابی و پاسخ — را با معیارها، روش ساخت مجموعه‌ی آزمون و تکنیک‌های بهبود می‌بینیم تا بدانید سیستم‌تان واقعاً چند درصد مواقع درست کار می‌کند.

RAG یا Fine-tuning؟ کدام برای کدام مسئله

RAG یا Fine-tuning؟ کدام برای کدام مسئله

این دو مکمل‌اند نه رقیب؛ اما انتخاب اشتباه بین‌شان بودجه‌ی پروژه را می‌سوزاند. در این مطلب تفاوت دقیق RAG و Fine-tuning را می‌بینیم، جدول تصمیم می‌گیریم و ترکیب درست هر دو را می‌چینیم.

معماری ترنسفورمر چگونه کار می‌کند؟

معماری ترنسفورمر چگونه کار می‌کند؟

همه‌ی مدل‌های زبانی بزرگ — از ChatGPT تا Claude و Gemini — روی یک معماری مشترک ساخته شده‌اند: ترنسفورمر. در این مطلب بدون فرمول سنگین می‌بینیم این معماری چطور با مکانیزم توجه کار می‌کند و چرا از ۲۰۱۷ تاکنون جایگزین نشده است.

AGI چیست؟ تعریف، وضعیت فعلی و اختلاف‌نظرها

AGI چیست؟ تعریف، وضعیت فعلی و اختلاف‌نظرها

هوش مصنوعی عمومی یا AGI، پرتکرارترین وعده و مبهم‌ترین مفهوم این حوزه است. در این مطلب می‌بینیم AGI دقیقاً چه تعریفی دارد، چرا آزمایشگاه‌ها سر تعریفش اختلاف دارند، کجا ایستاده‌ایم و چه نشانه‌هایی را باید دید.

پنجره‌ی زمینه (Context Window) چیست؟

پنجره‌ی زمینه (Context Window) چیست؟

چرا مدل در گفتگوی طولانی «فراموش» می‌کند و چه زمانی سند پیوست بهتر از متن چسبانده است؟ در این مطلب پنجره‌ی زمینه را — بزرگ‌ترین محدودیت عملی کار با مدل‌های زبانی — ساده و کاربردی توضیح می‌دهیم.

عامل‌های کدنویس چه کارهایی می‌کنند؟ Devin، Claude Code و مرز توانایی‌ها

عامل‌های کدنویس چه کارهایی می‌کنند؟ Devin، Claude Code و مرز توانایی‌ها

عامل‌های کدنویس فقط تکمیل‌کننده‌ی کد نیستند؛ مأموریت می‌گیرند، مخزن را می‌گردند، تست می‌نویسند و PR می‌سازند. در این مطلب می‌بینیم این ابزارها واقعاً چه می‌کنند، کجا قوی‌اند و کجا هنوز به انسان نیاز دارند.

تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق

تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق

این سه اصطلاح به‌جای هم به کار می‌روند، اما هر کدام دایره‌ای داخل دیگری‌اند و مرزشان مهم است. در این مطلب مرز دقیق هر سه را با یک مثال واحد می‌بینیم و یاد می‌گیریم برای هر مسئله کدام ابزار درست است.

هزینه‌ی API هوش مصنوعی چطور محاسبه می‌شود؟

هزینه‌ی API هوش مصنوعی چطور محاسبه می‌شود؟

قیمت‌گذاری مدل‌ها بر اساس توکن است اما برآورد هزینه‌ی پروژه مهارت می‌خواهد. در این مطلب فرمول محاسبه، اجزای پنهان هزینه و پنج راهکار عملی کاهش مصرف را می‌بینیم.

ساخت اولین عامل هوش مصنوعی — آموزش گام‌به‌گام

ساخت اولین عامل هوش مصنوعی — آموزش گام‌به‌گام

در این آموزش عملی یک عامل واقعی می‌سازیم که می‌تواند از فایل‌ها گزارش بسازد: معماری، ابزارها، حلقه‌ی اجرا و نکات ایمنی. همه‌چیز با API سازگار با OpenAI و بدون فریم‌ورک سنگین.

عامل هوش مصنوعی چگونه کار می‌کند؟ حلقه‌ی فکر، ابزار، مشاهده

عامل هوش مصنوعی چگونه کار می‌کند؟ حلقه‌ی فکر، ابزار، مشاهده

پشت هر عامل یک حلقه‌ی ساده نشسته: برنامه‌ریزی، صدا زدن ابزار، خواندن نتیجه، تصمیم بعدی. در این مطلب همین حلقه را قدم‌به‌قدم با یک مأموریت واقعی دنبال می‌کنیم و می‌بینیم چرا بعضی مأموریت‌ها شکست می‌خورند.

مدل زبانی چگونه ساخته می‌شود؟ سه مرحله از داده تا دستیار

مدل زبانی چگونه ساخته می‌شود؟ سه مرحله از داده تا دستیار

یک مدل زبانی قبل از رسیدن به دست شما سه مرحله را طی می‌کند: پیش‌آموزش روی حجم عظیم متن، تنظیم دقیق برای تعامل، و یادگیری تقویتی با بازخورد انسانی. در این مطلب هر مرحله را می‌بینیم و می‌فهمیم چرا مدل خام با ChatGPT فرق دارد.
کاربرد عامل هوش مصنوعی در کسب‌وکار — از پشتیبانی تا تحلیل داده

کاربرد عامل هوش مصنوعی در کسب‌وکار — از پشتیبانی تا تحلیل داده

عامل‌ها برای کسب‌وکار چه می‌کنند و کجا واقعاً بازدهی دارند؟ در این مطلب سناریوهای عملی — پشتیبانی، محتوا، تحلیل داده و عملیات — را با معیارهای «کجا نکنیم» مرور می‌کنیم و نقشه‌ی شروع امن می‌دهیم.

پرامپت چیست و چطور پرامپت خوب بنویسیم؟

پرامپت چیست و چطور پرامپت خوب بنویسیم؟

پرامپت همان سفارشی است که به مدل می‌دهید؛ اگر جواب‌ها کلی و بی‌ربط می‌شوند، مشکل معمولا از همین‌جا شروع می‌شود. در این مطلب ساختار یک پرامپت خوب، تکنیک‌های عملی و اشتباه‌های رایج را با مثال می‌بینیم.

دسترسی به مدل‌های هوش مصنوعی بدون پرداخت ارزی

دسترسی به مدل‌های هوش مصنوعی بدون پرداخت ارزی

چرا کارت بانکی ایرانی در درگاه‌های بین‌المللی رد می‌شود، هر یک از راه‌های واسطه دقیقاً کجا می‌شکند، و با چه معیارهایی باید سرویس‌های بومی را سنجید. تحلیلی برای توسعه‌دهنده‌ها و تیم‌های محصول.

AI Coding Agent چیست و چگونه کار می‌کند؟

AI Coding Agent چیست و چگونه کار می‌کند؟

AI Coding Agent نسل جدید ابزارهای هوش مصنوعی برای برنامه‌نویسی است که برخلاف یک Chatbot یا ابزار ساده Code Completion، فقط کد تولید نمی‌کند؛ بلکه می‌تواند یک مسئله نرم‌افزاری را تحلیل کند، فایل‌های پروژه را بررسی کند، ابزارهای مختلف را اجرا کند، کد را تغییر دهد، تست‌ها را اجرا کند، نتیجه را بررسی کند و در صورت نیاز دوباره تلاش کند.

Qwen3.8 در برابر DeepSeek V4؛ کدام مدل برای برنامه‌نویسی بهتر است؟

Qwen3.8 در برابر DeepSeek V4؛ کدام مدل برای برنامه‌نویسی بهتر است؟

Qwen3.8 و DeepSeek V4 از مهم‌ترین مدل‌های نسل جدید برای برنامه‌نویسی، استدلال، استفاده از ابزارها و ساخت AI Coding Agent هستند. اما وقتی صحبت از انتخاب یک مدل برای توسعه نرم‌افزار می‌شود، دیگر نمی‌توان فقط به تعداد پارامترها یا یک Benchmark خاص نگاه کرد.

LLM چیست؟ مدل‌های زبانی بزرگ چگونه کار می‌کنند؟

LLM چیست؟ مدل‌های زبانی بزرگ چگونه کار می‌کنند؟

LLM یا Large Language Model به مدل‌های زبانی بزرگی گفته می‌شود که با استفاده از حجم عظیمی از داده‌های متنی آموزش دیده‌اند و می‌توانند وظایفی مانند تولید و خلاصه‌سازی متن، پاسخ‌گویی به پرسش‌ها، ترجمه، برنامه‌نویسی و تحلیل اطلاعات را انجام دهند.

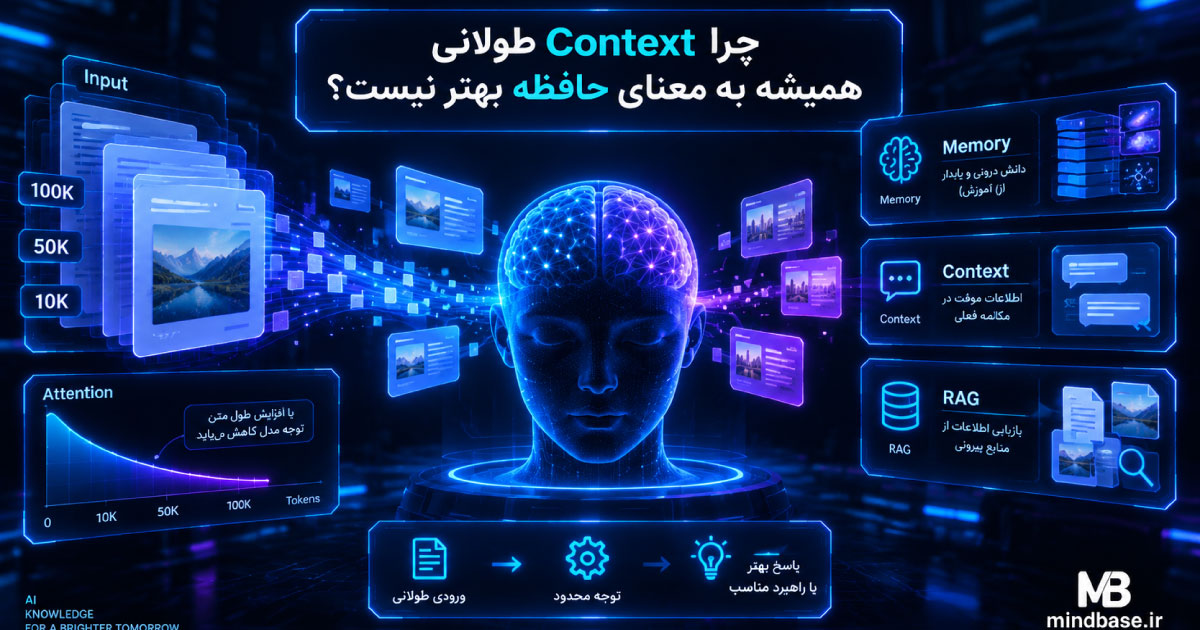
چرا Context طولانی همیشه به معنای حافظه بهتر نیست؟

چرا Context طولانی همیشه به معنای حافظه بهتر نیست؟

در سال‌های اخیر یکی از مهم‌ترین ویژگی‌هایی که هنگام معرفی مدل‌های هوش مصنوعی مورد توجه قرار می‌گیرد، اندازه Context Window است. مدل‌هایی با Context چندصد هزار یا حتی بیش از یک میلیون Token معرفی شده‌اند و این تصور به وجود آمده که هرچه Context بزرگ‌تر باشد، مدل حافظه بهتری دارد و می‌تواند اطلاعات بیشتری را به خاطر بسپارد. اما این تصور دقیق نیست.
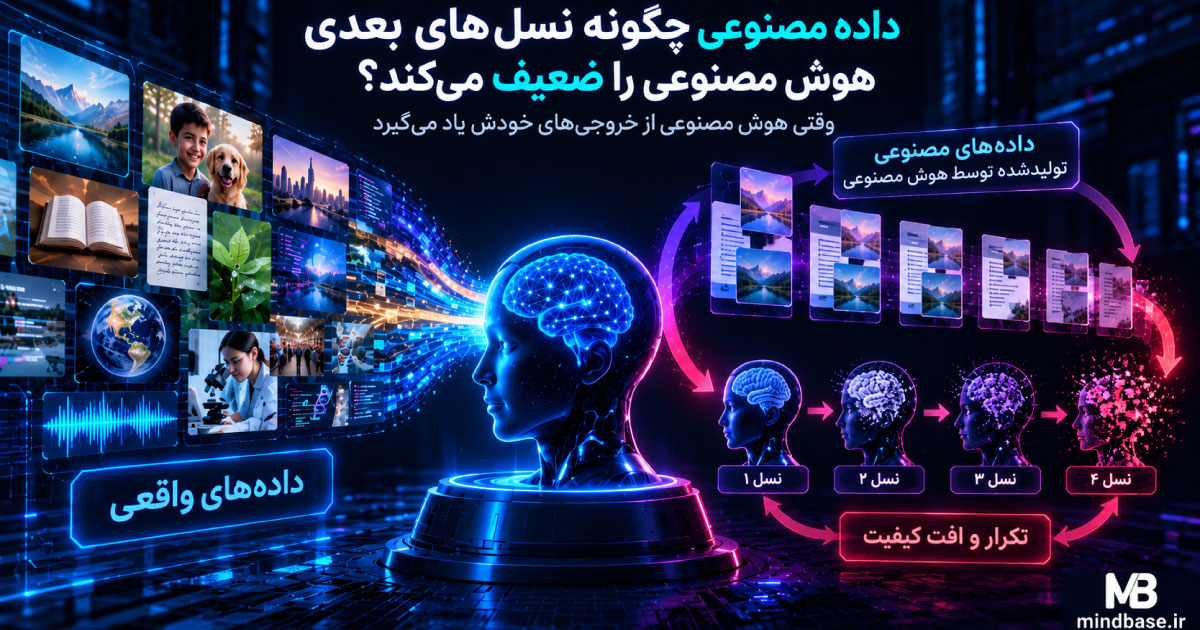
داده مصنوعی چگونه نسل‌های بعدی هوش مصنوعی را ضعیف می‌کند؟

داده مصنوعی چگونه نسل‌های بعدی هوش مصنوعی را ضعیف می‌کند؟

داده مصنوعی یا Synthetic Data یکی از مهم‌ترین ابزارهای توسعه نسل جدید مدل‌های هوش مصنوعی است. مدل‌های زبانی می‌توانند میلیون‌ها نمونه متن، کد، سؤال و پاسخ تولید کنند و از این داده‌ها برای آموزش مدل‌های دیگر استفاده شود.
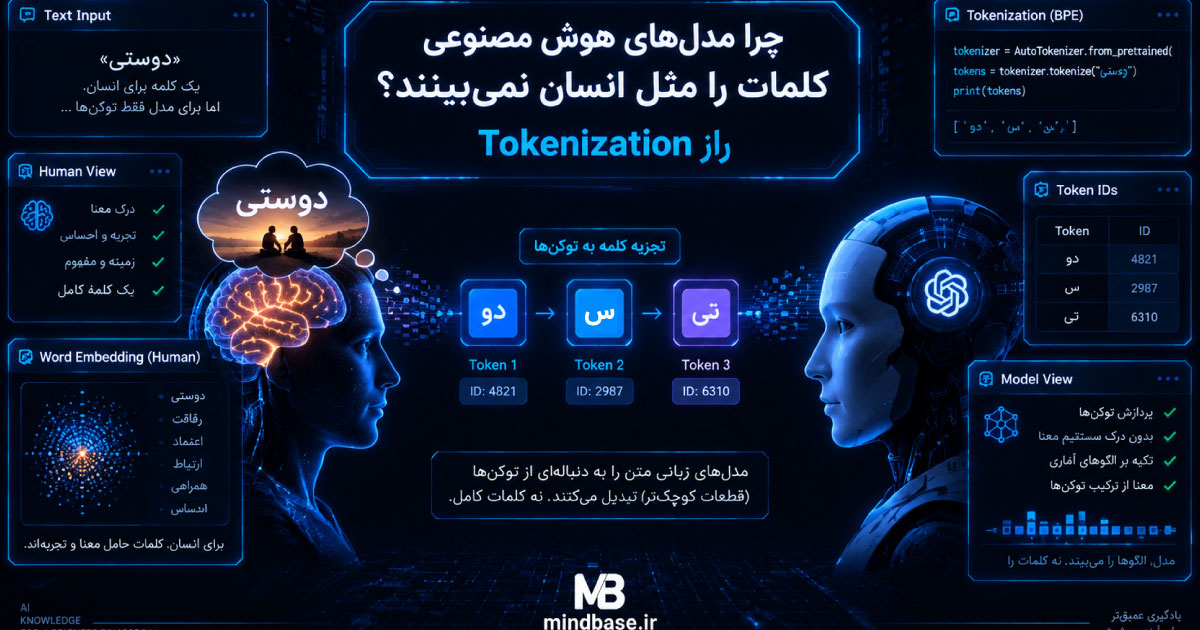
چرا مدل‌های هوش مصنوعی کلمات را مثل انسان نمی‌بینند؟ راز Tokenization

چرا مدل‌های هوش مصنوعی کلمات را مثل انسان نمی‌بینند؟ راز Tokenization

وقتی با یک مدل هوش مصنوعی صحبت می‌کنیم، معمولاً تصور می‌کنیم مدل جمله را دقیقاً همان‌طور که ما می‌بینیم، یعنی به شکل کلمه، دریافت می‌کند. اما پشت صحنه اتفاق متفاوتی رخ می‌دهد. مدل‌های زبانی مانند انسان با مفهوم «کلمه» کار نمی‌کنند. متن ابتدا توسط ابزاری به نام Tokenizer به واحدهایی به نام Token تقسیم می‌شود. این واحدها می‌توانند یک کلمه کامل، بخشی از یک کلمه، چند حرف، نشانه‌های نگارشی یا حتی بخش‌هایی از یک عبارت باشند.
Kimi K3 چیست؟ مدل هوش مصنوعی با میلیاردها پارامتر برای رقابت با بزرگان AI

Kimi K3 چیست؟ مدل هوش مصنوعی با میلیاردها پارامتر برای رقابت با بزرگان AI

Kimi K3 یکی از جدیدترین مدل‌های هوش مصنوعی شرکت Moonshot AI است که با هدف رقابت در سطح مدل‌های پیشرفته جهانی در حوزه‌های استدلال، برنامه‌نویسی، پژوهش، انجام وظایف Agentic و پردازش محتوای چندوجهی توسعه یافته است. این مدل با 2.8 تریلیون پارامتر، معماری Mixture of Experts، پنجره Context یک میلیون توکنی و قابلیت درک متن، تصویر و ویدئو، یکی از بزرگ‌ترین مدل‌های Open-Weight معرفی‌شده در سال 2026 محسوب می‌شود.

DeepSeek V4 چیست؟ معرفی نسل جدید مدل هوش مصنوعی DeepSeek

DeepSeek V4 چیست؟ معرفی نسل جدید مدل هوش مصنوعی DeepSeek

DeepSeek V4 نسل جدید خانواده مدل‌های هوش مصنوعی DeepSeek است که با تمرکز ویژه بر پردازش Context بسیار طولانی، استدلال، برنامه‌نویسی و انجام وظایف Agentic توسعه یافته است. این نسل شامل مدل‌های بسیار بزرگی مانند DeepSeek-V4-Pro با 1.6 تریلیون پارامتر و DeepSeek-V4-Flash با 284 میلیارد پارامتر است که هر دو از Context یک میلیون توکنی پشتیبانی می‌کنند.

Nemotron چیست؟ هوش مصنوعی NVIDIA برای توسعه‌دهندگان و شرکت‌ها

Nemotron چیست؟ هوش مصنوعی NVIDIA برای توسعه‌دهندگان و شرکت‌ها

Nemotron نام خانواده‌ای از مدل‌های هوش مصنوعی NVIDIA است که برای طیف گسترده‌ای از کاربردها، از مدل‌های زبانی و استدلال گرفته تا هوش مصنوعی چندوجهی، پردازش صوت و ساخت Agentهای سازمانی توسعه یافته‌اند.

Gemma 4 چیست؟ مدل متن‌باز گوگل برای اجرای شخصی هوش مصنوعی

Gemma 4 چیست؟ مدل متن‌باز گوگل برای اجرای شخصی هوش مصنوعی

Gemma 4 خانواده‌ای از مدل‌های هوش مصنوعی Google DeepMind است که با هدف ارائه قابلیت‌های پیشرفته هوش مصنوعی در اندازه‌ها و سخت‌افزارهای مختلف توسعه یافته‌اند. این خانواده از مدل‌های کوچک مناسب موبایل و دستگاه‌های لبه‌ای تا مدل‌های بزرگ‌تر برای لپ‌تاپ، ورک‌استیشن و سرور را شامل می‌شود.

Muse-Glimmer چیست؟ مدل جدید هوش مصنوعی چندوجهی

Muse-Glimmer چیست؟ مدل جدید هوش مصنوعی چندوجهی

Muse Glimmer یکی از مدل‌های جدید Meta Superintelligence Labs است که با یک هدف مشخص توسعه پیدا کرده است: ساخت یک مدل هوش مصنوعی قدرتمند برای اجرای محلی روی سخت‌افزارهای مصرفی که بتواند علاوه بر درک متن و تصویر، در نقش یک Agent نیز عمل کند. این مدل حدود ۳۰ میلیارد پارامتر دارد و برخلاف بسیاری از مدل‌های بزرگ که برای استفاده جدی به زیرساخت ابری وابسته هستند، برای اجرای Local روی کامپیوترهای شخصی، Mac و سیستم‌های مجهز به GPUهای مصرفی بهینه شده است.