
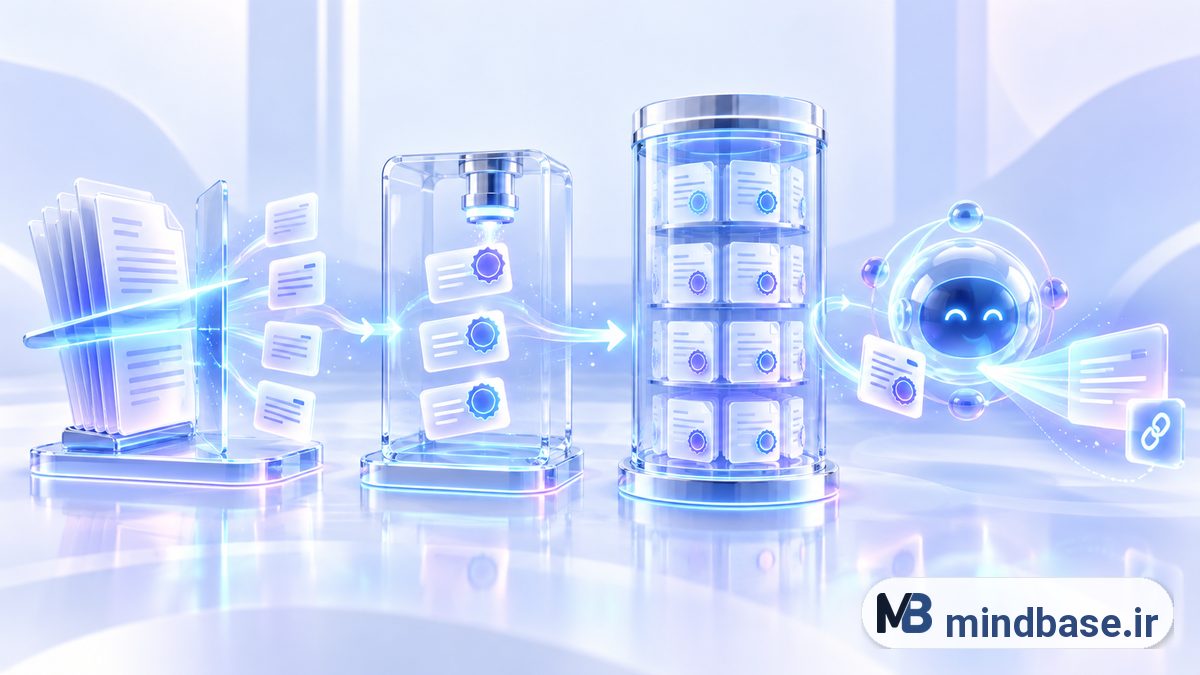
سیستم RAG به تعریف پیچیده نیاز ندارد: اسناد شما را «قابل جستوجوی معنایی» میکند و مدل زبانی را مجبور میکند از همانها جواب بدهد. در این آموزش همین دو کار را گامبهگام میسازیم — با ابزارهای ساده: امبدینگ از API مایندبیس و pgvector روی PostgreSQL. در پایان، یک API کوچک دارید که هر سؤال دربارهی اسنادتان را با ارجاع به منبع جواب میدهد.
نمای کلی معماری
دو مسیر جدا از هماند: مسیر شمارتسازی (یکبار و بعد از هر تغییر سند) — سند خوانده میشود، به تکهها شکسته میشود، هر تکه امبد میگیرد و با فرادادهاش در پایگاه داده مینشیند؛ و مسیر پرسش (در هر درخواست) — سؤال امبد میگیرد، نزدیکترین تکهها پیدا میشوند، بههمراه سؤال به مدل میروند و پاسخ مستند برمیگردد. تفکیک این دو مسیر مهم است: شمارتسازی سنگین و کمتکرار است؛ پرسش سبک و پرتکرار.
قدم اول: تکهبندی درست اسناد
مهمترین تصمیم کیفیتساز، همینجاست. تکهی خیلی کوچک، زمینهی کافی ندارد («گارانتی شامل...» بدون اینکه از چه محصولی حرف میزند)؛ تکهی خیلی بزرگ، نویز بیربط میآورد و سهم سند واقعی در پنجره کم میشود. نقطهی شروع کارا: تکههای ۳۰۰ تا ۵۰۰ توکنی با ۵۰ توکن همپوشانی، و ترجیح شکستن در مرز طبیعی — پاراگراف، تیتر — نه وسط جمله. قاعدهی طلایی: تکه باید «خودکفا» باشد؛ کسی که فقط همین تکه را بخواند، بفهمد دربارهی چیست:
def chunk_text(text, size=1200, overlap=200):
    chunks, start = [], 0
    while start < len(text):
        end = min(start + size, len(text))
        # شکستن در مرز پاراگراف اگر نزدیک بود
        cut = text.rfind("\n\n", start + size * 0.6, end)
        if cut > start: end = cut
        chunks.append(text[start:end].strip())
        start = end - overlap if end < len(text) else end
    return [c for c in chunks if c]
قدم دوم: امبدینگ و ذخیرهسازی
هر تکه را امبد میگیریم و در pgvector میگذاریم — همراه با فراداده: آدرس سند، شماره تکه، تاریخ. فراداده را دستکم نگیرید: بدون آن نمیتوانید فیلتر کنید («فقط مستندات این محصول») یا پاسخ را به منبع ارجاع دهید:
from openai import OpenAI
client = OpenAI(base_url="https://api.mindbase.ir/v1", api_key="KEY")
def embed(text):
r = client.embeddings.create(model="embedding-model", input=text)
return r.data[0].embedding
# جدول در PostgreSQL با افزونهی pgvector:
# CREATE EXTENSION vector;
# CREATE TABLE chunks (id bigserial primary key, doc text, pos int,
# content text, embedding vector(1024), created_at date);
def index_document(doc_name, text):
for i, ch in enumerate(chunk_text(text)):
db.execute(
"INSERT INTO chunks (doc, pos, content, embedding) VALUES (%s,%s,%s,%s)",
(doc_name, i, ch, embed(ch)))قدم سوم: بازیابی
در زمان پرسش، سؤال امبد میگیرد و نزدیکترین تکهها با جستوجوی برداری پیدا میشوند. شروع با k=۵ معمولاً درست است؛ فیلتر فراداده را قبل از جستوجو اعمال کنید تا جستوجو فقط در دامنهی مجاز بچرخد:
def retrieve(question, k=5, doc_filter=None):
    q = embed(question)
    rows = db.execute("""
        SELECT doc, pos, content, embedding <=> %s::vector AS dist
        FROM chunks WHERE (%s IS NULL OR doc = %s)
        ORDER BY embedding <=> %s::vector LIMIT %s""",
        (q, doc_filter, doc_filter, q, k)).fetchall()
    return rows
قدم چهارم: تولید پاسخ مستند
حالا تکهها و سؤال به مدل میروند با پرامپتی که نقش و مرز را دقیق تعریف میکند:
def answer(question):
hits = retrieve(question)
context = "\n\n".join(
f"[منبع: {h.doc} | تکه {h.pos}]\n{h.content}" for h in hits)
prompt = f"""بر اساس فقط منابع زیر پاسخ بده. خارج از آنها حدس نزن.
اگر پاسخ در منابع نیست، صریح بگو «در مستندات موجود نیست».
پایان پاسخ، فهرست منابع استفادهشده را بیاور.
سؤال: {question}
منابع:
{context}"""
r = client.chat.completions.create(
model="glm-5.3",
messages=[{"role": "user", "content": prompt}])
return r.choices[0].message.contentپنج نکتهای که سیستم معمولی را حرفهای میکند
- مرزبندی امتیاز: اگر فاصلهی بهترین نتیجه هم بد بود («هیچ تکهای به سؤال نزدیک نیست»)، مدل را مجبور به پاسخ نکنید؛ «پیدا نکردم» پاسخ درست است.
- بازیابی ترکیبی: برای نام محصول، شماره مدل و اصطلاحات دقیق، جستوجوی کلمهای را با برداری ترکیب کنید؛ جستوجوی خالص معنایی روی اسامی خاص ضعیف است.
- بازچینش (Rerank): در سیستمهای جدی، ۲۰ کاندیدا را بگیرید و با یک مدل بازچینش به ۵ بهترین برسید؛ دقت بازیابی را محسوس بالا میبرد.
- تازهسازی شمارتسازی: تغییر سند باید در ایندکس هم بیاید — webhook یا کار زمانبندیشده؛ سند کهنه یعنی پاسخ کهنه.
- نمایش منبع به کاربر: ارجاعها اعتماد میسازند و خطا را قابل کشف میکنند؛ بدون منبع، RAG فقط «توهم ملبّس» است.
جمعبندی
سیستم RAG حداقلی از چهار قطعه ساخته میشود: تکهبندی خودکفا، ذخیرهی برداری با فراداده، بازیابی با مرز امتیاز، و تولید مستند با اجازهی «نمیدانم». همین اسکلت — با ارتقاهای بازیابی ترکیبی و بازچینش — پایهی چتباتهای سازمانی جدی است. قدم بعدی طبیعی این مسیر: قبل از عرضه، ارزیابی کیفیت بازیابی و پاسخ را یاد بگیرید؛ RAG بدون اندازهگیری، سیستمِ کور است.