
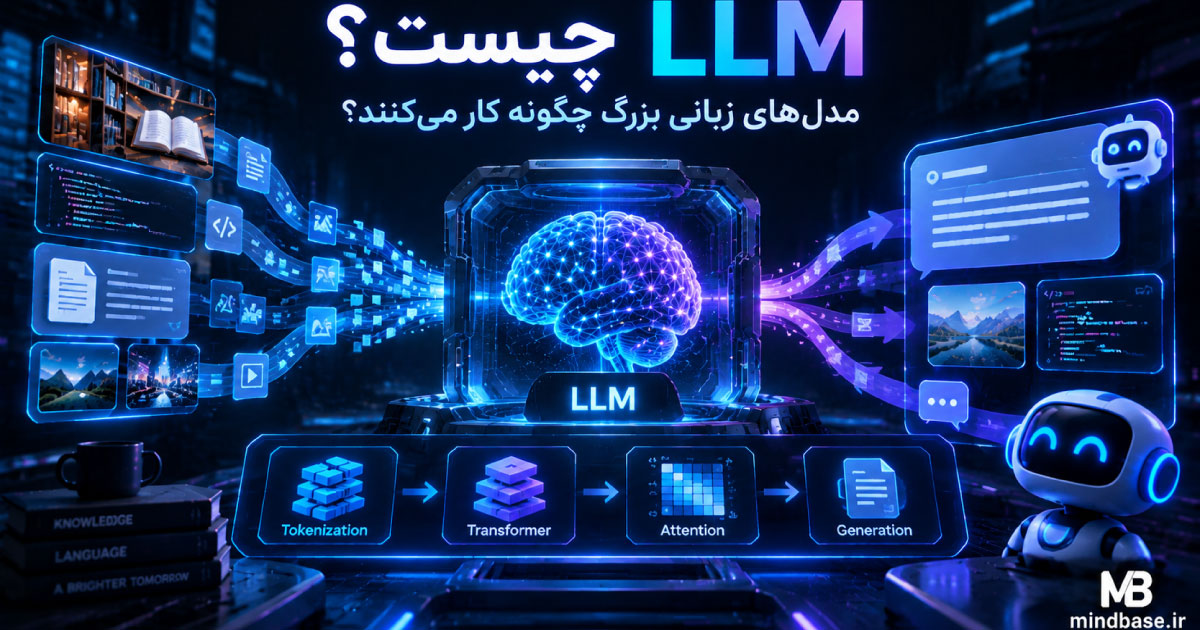
LLM چیست؟
LLM مخفف Large Language Model به معنی «مدل زبانی بزرگ» است. این مدلها نوعی مدل هوش مصنوعی هستند که برای پردازش و تولید زبان انسانی با استفاده از حجم بسیار زیادی از دادهها آموزش دیدهاند.
مدلهای LLM امروزی میتوانند متن تولید کنند، به سؤال پاسخ دهند، متن را خلاصه کنند، زبانها را ترجمه کنند، کد بنویسند، اسناد را تحلیل کنند و در بسیاری از موارد با ابزارها و نرمافزارهای دیگر نیز تعامل داشته باشند.
مدلهایی مانند GPT، Claude، Llama، Qwen، Gemma و DeepSeek نمونههایی از خانواده مدلهای زبانی بزرگ هستند.
اما یک نکته مهم وجود دارد: LLM لزوماً به معنی «چتبات» نیست.
LLM یک مدل است. چتبات یا دستیار هوشمند، معمولاً یک محصول یا سیستم ساختهشده روی یک یا چند مدل است. برای مثال، یک مدل زبانی میتواند موتور اصلی یک دستیار برنامهنویسی، ابزار تولید محتوا یا AI Agent باشد.
به زبان ساده، LLM را میتوان مغز زبانی یک سیستم هوشمند در نظر گرفت، اما محصول نهایی میتواند چیز بسیار بزرگتری از خود مدل باشد.
چرا به آن Large Language Model میگویند؟
عبارت Large Language Model از سه بخش تشکیل شده است:
Large
یعنی مدل معمولاً تعداد بسیار زیادی پارامتر دارد و با حجم بزرگی از دادهها آموزش میبیند.
Language
یعنی هدف اصلی آن یادگیری الگوهای مربوط به زبان و تولید یا پردازش متن است.
Model
یعنی یک مدل ریاضی و محاسباتی که الگوهای موجود در دادههای آموزشی را در قالب پارامترهای خود یاد میگیرد.
البته همه LLMها دقیقاً یک اندازه یا یک معماری ندارند.
برخی مدلها چند میلیارد پارامتر دارند و میتوانند روی سختافزارهای نسبتاً معمولی اجرا شوند. برخی دیگر صدها میلیارد یا حتی تریلیونها پارامتر دارند و برای آموزش و اجرای آنها به زیرساخت محاسباتی بسیار قدرتمندی نیاز است.
به همین دلیل، تعداد پارامترها به تنهایی معیار مناسبی برای تعیین کیفیت یک مدل نیست. معماری، کیفیت داده، روش آموزش، بهینهسازی، قابلیت استدلال، Context Window و نحوه استفاده از مدل نیز اهمیت زیادی دارند.
LLM چگونه زبان را یاد میگیرد؟
یکی از مهمترین نکات درباره LLM این است که مدل زبان را دقیقاً به همان شکلی که انسان یاد میگیرد، یاد نمیگیرد.
مدل ابتدا متن را دریافت میکند و آن را به Token تبدیل میکند. Tokenها واحدهایی هستند که مدل میتواند آنها را پردازش کند. Token ممکن است یک کلمه کامل، بخشی از یک کلمه، یک علامت یا ترکیبی از این موارد باشد.
سپس مدل در فرآیند آموزش، الگوهای آماری موجود در توالی Tokenها را یاد میگیرد.
در مدلهای زبانی مولد مانند GPT، یکی از اهداف اصلی آموزش، پیشبینی Token بعدی است.
برای مثال اگر مدل این عبارت را ببیند:
«امروز هوا خیلی»
ممکن است احتمال Tokenهای مختلف را محاسبه کند و مثلاً «خوب»، «سرد»، «گرم» یا کلمات دیگر را به عنوان ادامه احتمالی در نظر بگیرد.
مدل این کار را در مقیاس بسیار بزرگ و روی حجم عظیمی از داده انجام میدهد.
مستندات Hugging Face نیز Causal Language Modeling را روشی معرفی میکنند که در آن مدل Token بعدی را بر اساس Tokenهای قبلی پیشبینی میکند و اجازه مشاهده Tokenهای آینده را ندارد.
LLM واقعاً «کلمات» را نمیبیند
یکی از سوءتفاهمهای رایج این است که تصور کنیم مدل جمله را دقیقاً مانند انسان میخواند.
در واقع، مدل ابتدا متن را Tokenize میکند.
برای مثال یک جمله ممکن است به چندین Token تبدیل شود. بنابراین مدل مستقیماً با مفهوم «کلمه» به معنای انسانی آن کار نمیکند، بلکه با نمایش عددی Tokenها کار میکند.
فرآیند کلی را میتوان اینگونه تصور کرد:
متن
↓
Tokenizer
↓
Tokenها
↓
شناسههای عددی Token
↓
Embedding
↓
Transformer
↓
احتمال Token بعدی
↓
Token جدید
↓
تبدیل Tokenها به متن
به همین دلیل Tokenization یکی از مهمترین بخشهای سیستمهای LLM است.
در مقاله دیگری از مجموعه MindBase با عنوان «چرا مدلهای هوش مصنوعی کلمات را مثل انسان نمیبینند؟ راز Tokenization» این فرآیند را به صورت دقیقتر بررسی کردهایم.
Transformer چیست؟
بخش بزرگی از LLMهای مدرن بر پایه معماری Transformer ساخته شدهاند.
Transformer معماریای است که امکان پردازش مؤثر توالیهای متنی و یادگیری ارتباط میان بخشهای مختلف یک ورودی را فراهم میکند.
یکی از مهمترین ایدههای Transformer، Attention است.
Attention چگونه کار میکند؟
Attention به مدل کمک میکند هنگام پردازش یک Token، ارتباط آن را با Tokenهای دیگر در متن در نظر بگیرد.
برای مثال در جمله:
«علی کتاب را برداشت چون میخواست آن را بخواند.»
مدل باید بتواند ارتباط میان بخشهای مختلف جمله را در نظر بگیرد تا بفهمد «آن» به چه چیزی اشاره میکند.
در مدلهای مدرن، سازوکار Attention در کنار لایههای مختلف شبکه عصبی قرار میگیرد و بارها روی نمایش داخلی Tokenها اعمال میشود.
Hugging Face در دوره آموزشی خود توضیح میدهد که مدلهای Transformer از جمله GPT و BERT به عنوان مدلهای زبانی روی حجم بزرگی از متن آموزش داده میشوند و بسته به معماری و هدف آموزشی، از روشهایی مانند Causal Language Modeling یا Masked Language Modeling استفاده میکنند.
Causal Language Modeling چیست؟
یکی از روشهای اصلی آموزش مدلهای زبانی مولد، Causal Language Modeling یا CLM است.
در این روش، مدل باید Token بعدی را با توجه به Tokenهای قبلی پیشبینی کند.
برای مثال:
«هوش مصنوعی در سالهای اخیر»
مدل تلاش میکند احتمال Token بعدی را محاسبه کند.
ممکن است چندین Token مختلف احتمال داشته باشند. مدل بر اساس توزیع احتمالات، یکی را انتخاب میکند.
بعد همان Token به ورودی اضافه میشود و مدل Token بعدی را پیشبینی میکند.
این فرآیند بارها تکرار میشود.
فرآیند تولید متن
Prompt
↓
پیشبینی Token بعدی
↓
اضافه کردن Token
↓
پیشبینی Token بعدی
↓
اضافه کردن Token
↓
ادامه فرآیند
↓
تولید پاسخ
مستندات Hugging Face نیز همین سازوکار را برای مدلهای Causal Language Model توضیح میدهند و GPT-2 را نمونهای از این نوع مدل معرفی میکنند.
آیا LLM فقط Token بعدی را حدس میزند؟
از نظر فنی، در بسیاری از مدلهای زبانی مولد، تولید متن بر اساس پیشبینی Token بعدی انجام میشود.
اما این توضیح به تنهایی تصویر کاملی از توانایی مدل ارائه نمیدهد.
مدل هنگام آموزش روی حجم عظیمی از داده، الگوهای پیچیدهای را در پارامترهای خود یاد میگیرد. این الگوها میتوانند مربوط به دستور زبان، ساختار متن، ارتباط میان مفاهیم، الگوهای برنامهنویسی، سبکهای نوشتاری و روابط مختلف میان اطلاعات باشند.
بنابراین وقتی میگوییم «مدل Token بعدی را پیشبینی میکند»، نباید تصور کنیم که این کار شبیه یک جستوجوی ساده در یک فهرست کلمات است.
مدل برای تولید Token بعدی از نمایشهای عددی و محاسبات بسیار پیچیدهای استفاده میکند که در طول آموزش شکل گرفتهاند.
پارامترهای LLM چه هستند؟
پارامترها مقادیری عددی هستند که در فرآیند آموزش مدل تغییر میکنند.
به زبان ساده، پارامترها بخشی از چیزی هستند که مدل از دادههای آموزشی یاد میگیرد.
وقتی درباره مدلهای 7B، 30B، 70B یا مدلهای بزرگتر صحبت میکنیم، حرف B معمولاً به میلیاردها پارامتر اشاره دارد.
برای مثال:
7B یعنی حدود 7 میلیارد پارامتر
30B یعنی حدود 30 میلیارد پارامتر
70B یعنی حدود 70 میلیارد پارامتر
اما تعداد پارامتر بیشتر الزاماً به معنی مدل بهتر نیست.
یک مدل کوچکتر با داده بهتر، معماری مناسبتر و آموزش بهتر ممکن است در یک وظیفه خاص از یک مدل بسیار بزرگتر عملکرد بهتری داشته باشد.
از طرف دیگر، تعداد پارامترها روی هزینه حافظه و محاسبات نیز تأثیر میگذارد و به همین دلیل مدلهای بزرگتر معمولاً به منابع سختافزاری بیشتری نیاز دارند.
LLM چگونه آموزش داده میشود؟
آموزش یک LLM را میتوان به چند مرحله اصلی تقسیم کرد.
مرحله اول: جمعآوری داده
مدل به حجم بسیار زیادی از دادههای متنی نیاز دارد.
این دادهها میتوانند شامل کتابها، صفحات وب، اسناد، کدهای برنامهنویسی و منابع متنی مختلف باشند.
کیفیت داده اهمیت بسیار زیادی دارد. حجم بالا به تنهایی کافی نیست و دادههای تکراری، بیکیفیت، آلوده یا نامناسب میتوانند کیفیت مدل را کاهش دهند.
مرحله دوم: Tokenization
دادههای متنی به Token تبدیل میشوند.
Tokenizer متن را به واحدهایی تقسیم میکند که مدل بتواند آنها را به شکل عددی پردازش کند.
مرحله سوم: Pretraining
در مرحله Pretraining، مدل روی حجم عظیمی از دادهها آموزش میبیند.
در یک مدل Causal Language Model، هدف اصلی معمولاً پیشبینی Token بعدی است.
مدل در ابتدا عملکرد خوبی ندارد، اما با دیدن نمونههای بسیار زیاد، پارامترهای خود را بهتدریج تنظیم میکند.
Hugging Face توضیح میدهد که Pretraining یک مدل از ابتدا به منابع محاسباتی بسیار بیشتری نسبت به Fine-Tuning یک مدل از قبل آموزشدیده نیاز دارد.
مرحله چهارم: Fine-Tuning
بعد از Pretraining، مدل میتواند برای کاربردها یا رفتارهای مشخصتر Fine-Tune شود.
برای مثال میتوان مدل را روی دادههای مناسب برای موارد زیر آموزش داد:
- پاسخگویی به دستورها
- برنامهنویسی
- گفتوگو
- پاسخ به پرسشهای تخصصی
- تولید محتوا
- وظایف خاص
به همین دلیل مدل پایه و مدل آماده استفاده ممکن است رفتار کاملاً متفاوتی داشته باشند.
مدل Base با مدل Chat چه تفاوتی دارد؟
مدل Base معمولاً همان مدل اصلی است که مرحله Pretraining را پشت سر گذاشته است.
این مدل میتواند زبان و الگوهای آن را یاد گرفته باشد، اما الزاماً برای دنبال کردن دستورهای انسانی یا مکالمه بهینه نشده است.
در مرحلههای بعدی میتوان مدل را با دادههای دستورمحور و روشهای دیگر آموزش داد تا بهتر بتواند درخواست کاربر را دنبال کند.
به همین دلیل مدلهای یک خانواده ممکن است نسخههای مختلفی مانند موارد زیر ارائه کنند:
- Base
- Instruct
- Chat
- Reasoning
- Code
هرکدام میتوانند برای هدف متفاوتی بهینه شده باشند.
LLM چگونه به یک سؤال پاسخ میدهد؟
وقتی یک Prompt به مدل ارسال میکنیم، فرآیند تولید پاسخ تقریباً به این شکل است:
- متن Prompt دریافت میشود.
- Prompt توسط Tokenizer به Token تبدیل میشود.
- Tokenها به شناسههای عددی تبدیل میشوند.
- این دادهها وارد مدل میشوند.
- Transformer روابط میان Tokenها را پردازش میکند.
- مدل برای Token بعدی یک توزیع احتمال تولید میکند.
- یک Token انتخاب میشود.
- Token جدید به توالی اضافه میشود.
- فرآیند دوباره تکرار میشود.
- در نهایت Tokenها به متن قابل خواندن تبدیل میشوند.
این مرحله را Inference مینامیم.
Hugging Face در مستندات Transformers نیز برای مدلهای Causal Language Model فرآیند Tokenization، اجرای مدل و استفاده از generate برای تولید Tokenهای جدید را نشان میدهد.
Inference چیست؟
Inference به مرحله استفاده از مدل آموزشدیده برای تولید خروجی گفته میشود.
در آموزش، مدل پارامترهای خود را تغییر میدهد.
در Inference، معمولاً پارامترهای مدل ثابت هستند و مدل از آنچه یاد گرفته برای پاسخ دادن به ورودی جدید استفاده میکند.
مثلاً وقتی در یک چتبات سؤال میپرسید، مدل دوباره از ابتدا آموزش نمیبیند.
در عوض، ورودی را دریافت کرده و با استفاده از وزنها و پارامترهای موجود، خروجی تولید میکند.
Temperature چه نقشی دارد؟
تولید متن همیشه به این معنی نیست که مدل باید محتملترین Token را انتخاب کند.
پارامترهایی مانند Temperature میتوانند روی نحوه انتخاب Token تأثیر بگذارند.
Temperature پایینتر معمولاً خروجی را قابل پیشبینیتر میکند.
Temperature بالاتر میتواند تنوع بیشتری در خروجی ایجاد کند.
برای مثال در یک پاسخ دقیق و فنی ممکن است خروجی کنترلشدهتر مطلوب باشد، در حالی که برای تولید ایدههای خلاقانه میتوان تنوع بیشتری را ترجیح داد.
پارامترهایی مانند Top-K و Top-P نیز میتوانند روی فرآیند انتخاب Token تأثیر بگذارند.
این موضوع را در مقاله «Temperature، Context Window و Token در مدلهای AI یعنی چه؟» به شکل جداگانه بررسی کردهایم.
Context Window چیست؟
مدل برای تولید پاسخ فقط به یک Token منفرد نگاه نمیکند.
مدل میتواند مجموعهای از Tokenهای موجود در ورودی و تاریخچه در دسترس را در قالب Context پردازش کند.
به حداکثر مقدار Tokenهایی که یک مدل میتواند در یک درخواست پردازش کند، Context Window گفته میشود.
برای مثال، اگر مدلی Context Window بسیار بزرگی داشته باشد، میتواند حجم بیشتری از متن را در یک درخواست دریافت کند.
اما Context Window با حافظه دائمی یکی نیست.
این تفاوت بسیار مهم است.
اگر اطلاعاتی خارج از Context فعلی قرار داشته باشد، مدل لزوماً به آن دسترسی ندارد.
به همین دلیل سیستمهای مدرن معمولاً در کنار LLM از روشهایی مانند Memory، RAG و پایگاههای داده استفاده میکنند.
آیا LLM واقعاً اطلاعات را به خاطر میسپارد؟
این سؤال پاسخ سادهای ندارد.
در طول آموزش، اطلاعات و الگوهای موجود در دادهها میتوانند در پارامترهای مدل منعکس شوند.
اما این با حافظه انسانی یکسان نیست.
مدل هنگام پاسخگویی به یک Prompt، اطلاعات موجود در Context را نیز پردازش میکند.
همچنین یک سیستم هوشمند میتواند از حافظه خارجی یا RAG استفاده کند تا اطلاعات موردنیاز را در زمان پاسخگویی بازیابی کند.
بنابراین بهتر است سه مفهوم را از هم جدا کنیم:
Parameters
دانشی که در وزنها و پارامترهای مدل شکل گرفته است.
Context
اطلاعاتی که در درخواست فعلی در اختیار مدل قرار گرفته است.
RAG و حافظه خارجی
اطلاعاتی که خارج از پارامترهای مدل ذخیره شده و هنگام نیاز بازیابی میشوند.
این تفکیک برای طراحی سیستمهای هوش مصنوعی بسیار مهم است.
چرا LLMها میتوانند کدنویسی کنند؟
اگر مدل روی حجم زیادی از کدهای باکیفیت آموزش دیده باشد، میتواند الگوهای موجود در زبانهای برنامهنویسی و ساختار کد را یاد بگیرد.
به همین دلیل مدلهای زبانی میتوانند:
- کد تولید کنند
- کد را توضیح دهند
- خطاهای احتمالی را پیدا کنند
- کد را بازنویسی کنند
- تست تولید کنند
- بین زبانهای برنامهنویسی ترجمه انجام دهند
- و حتی در سیستمهای Agentic Coding با ابزارهای توسعه نرمافزار تعامل داشته باشند
Hugging Face نیز مدلهای Causal Language Model را برای کاربردهایی مانند تولید متن و دستیارهای برنامهنویسی معرفی میکند.
آیا LLM واقعاً فکر میکند؟
این یکی از بحثبرانگیزترین موضوعات درباره مدلهای زبانی است.
بهتر است میان «توانایی حل مسئله» و «تفکر انسانی» تفاوت قائل شویم.
LLM میتواند در بسیاری از مسائل پیچیده، زنجیرهای از مراحل را تولید و پردازش کند و مدلهای جدید Reasoning نیز برای حل مسائل پیچیدهتر طراحی شدهاند.
اما این موضوع به خودی خود ثابت نمیکند که مدل دقیقاً مانند انسان فکر میکند یا دارای تجربه ذهنی و آگاهی انسانی است.
به همین دلیل عبارتهایی مانند «مدل فکر میکند» معمولاً باید با احتیاط استفاده شوند.
از دید فنی، چیزی که میتوانیم مشاهده کنیم، محاسبات مدل و خروجی آن است.
تفاوت LLM با Chatbot چیست؟
LLM یک مدل است.
Chatbot یک سیستم تعاملی است که میتواند از LLM استفاده کند.
برای مثال یک Chatbot ممکن است شامل این اجزا باشد:
- رابط کاربری
- LLM
- مدیریت Context
- Memory
- RAG
- پایگاه داده
- سیستم احراز هویت
- ابزارهای مختلف
- APIها
- سیستم کنترل دسترسی
بنابراین ساخت یک Chatbot حرفهای بسیار فراتر از اتصال یک مدل زبانی به یک کادر متن است.
تفاوت LLM با AI Agent چیست؟
یک LLM عمدتاً وظیفه پردازش و تولید اطلاعات را بر عهده دارد.
اما AI Agent میتواند از مدل برای تصمیمگیری و اجرای مجموعهای از اقدامات استفاده کند.
برای مثال یک LLM میتواند پاسخ دهد:
«برای این مشکل بهتر است پایگاه داده بررسی شود.»
یک Agent میتواند:
- پایگاه داده را بررسی کند.
- اطلاعات را تحلیل کند.
- یک API را فراخوانی کند.
- نتیجه را بررسی کند.
- سپس اقدام بعدی را انجام دهد.
به همین دلیل LLM یکی از اجزای مهم بسیاری از Agentها است، اما Agent الزاماً مساوی با LLM نیست.
چرا LLMها گاهی پاسخ اشتباه میدهند؟
LLMها همیشه یک پایگاه حقیقت قطعی نیستند.
مدل میتواند پاسخی تولید کند که از نظر زبانی کاملاً منطقی به نظر برسد اما از نظر واقعی اشتباه باشد.
به این پدیده معمولاً Hallucination گفته میشود.
یکی از دلایل آن این است که هدف مدل در بسیاری از فرآیندهای تولید متن، تولید توالی محتمل Tokenها است، نه تضمین حقیقت هر ادعا.
برای کاهش این مشکل میتوان از روشهایی مانند موارد زیر استفاده کرد:
- RAG
- منابع معتبر
- Tool Calling
- جستوجوی وب
- پایگاههای داده اختصاصی
- اعتبارسنجی خروجی
- Human-in-the-loop
آیا هرچه LLM بزرگتر باشد بهتر است؟
خیر.
این یکی از سادهترین دامهای دنیای AI است: دیدن یک عدد بزرگ و نتیجهگیری سریع.
تعداد پارامترها مهم است، اما تنها معیار نیست.
کیفیت داده، معماری مدل، روش آموزش، کیفیت Fine-Tuning، طول Context، توانایی استدلال، بهینهسازی Inference و هدف مدل هم اهمیت دارند.
یک مدل کوچکتر ممکن است برای یک کاربرد خاص بسیار مناسبتر از یک مدل بزرگ باشد.
به همین دلیل انتخاب مدل باید بر اساس کاربرد واقعی انجام شود، نه فقط تعداد پارامترها.
LLMهای متنباز و Open-Weight چه تفاوتی دارند؟
در اکوسیستم هوش مصنوعی مدلهای مختلفی با شرایط انتشار متفاوت وجود دارند.
برخی مدلها به صورت Open-Weight منتشر میشوند و وزنهای آنها در اختیار کاربران قرار میگیرد.
پلتفرمهایی مانند Hugging Face Hub امکان انتشار، اشتراکگذاری و استفاده از مدلها و Datasetهای مختلف را فراهم میکنند.
در نتیجه توسعهدهندگان میتوانند مدلهای مختلف را بررسی کنند، آنها را روی زیرساخت خود اجرا کنند یا برای کاربردهای خاص تغییر دهند.
البته «Open» در مورد همه مدلها دقیقاً یک معنی ندارد.
مجوز مدل، وزنها، دادههای آموزشی، کد آموزش و محدودیتهای استفاده باید جداگانه بررسی شوند.
آینده LLMها به کدام سمت میرود؟
مدلهای زبانی در حال تبدیل شدن از ابزارهای ساده تولید متن به بخشی از سیستمهای پیچیدهتر هوشمند هستند.
چند روند مهم را میتوان در این مسیر مشاهده کرد.
مدلهای چندوجهی
مدلها دیگر فقط متن را پردازش نمیکنند و قابلیت درک تصویر، صدا و ویدئو در حال گسترش است.
Contextهای طولانیتر
مدلهای جدید میتوانند حجم بسیار بیشتری از اطلاعات را در یک درخواست پردازش کنند.
Reasoning
مدلها بیشتر روی حل مسائل چندمرحلهای و استدلال پیچیده تمرکز میکنند.
AI Agent
مدلها به جای اینکه فقط پاسخ تولید کنند، میتوانند در قالب Agent با ابزارها و محیطهای مختلف تعامل داشته باشند.
مدلهای کوچکتر و Local
مدلهای کوچک و Quantized امکان اجرای AI روی سختافزارهای شخصی و دستگاههای مختلف را بیشتر میکنند.
Multimodal AI
ترکیب متن، تصویر، صدا و ویدئو به یکی از مسیرهای مهم توسعه مدلهای جدید تبدیل شده است.
در نتیجه آینده LLM فقط درباره «مدل بزرگتر» نیست؛ بلکه درباره مدلهایی است که بهتر، سریعتر، ارزانتر، چندوجهیتر و قابل استفادهتر باشند.
جمعبندی
LLM یا Large Language Model یکی از مهمترین فناوریهای زیربنایی موج جدید هوش مصنوعی است.
این مدلها با آموزش روی حجم بسیار زیادی از داده، الگوهای پیچیده زبان را یاد میگیرند و میتوانند برای تولید و پردازش متن، برنامهنویسی، تحلیل اطلاعات، ترجمه و بسیاری از وظایف دیگر استفاده شوند.
در بسیاری از LLMهای مولد، فرآیند تولید متن بر پایه پیشبینی Token بعدی انجام میشود. Tokenها ابتدا توسط Tokenizer پردازش میشوند و سپس در معماریهایی مانند Transformer، ارتباط میان آنها بررسی میشود.
پس از آموزش، مدل میتواند در مرحله Inference بر اساس Prompt و Context موجود، Tokenهای جدید تولید کند و در نهایت آنها را به متن قابل خواندن تبدیل کند.
اما LLM به تنهایی تمام سیستم هوش مصنوعی نیست.
وقتی LLM در کنار RAG، Memory، ابزارها، Function Calling، APIها و Agentها قرار میگیرد، میتوان سیستمهایی ساخت که بسیار فراتر از یک چتبات ساده عمل میکنند.
به همین دلیل برای درک نسل جدید سیستمهای هوش مصنوعی، شناخت مفاهیمی مانند Token، Transformer، Context، RAG، Fine-Tuning، Reasoning و AI Agent اهمیت زیادی دارد.