
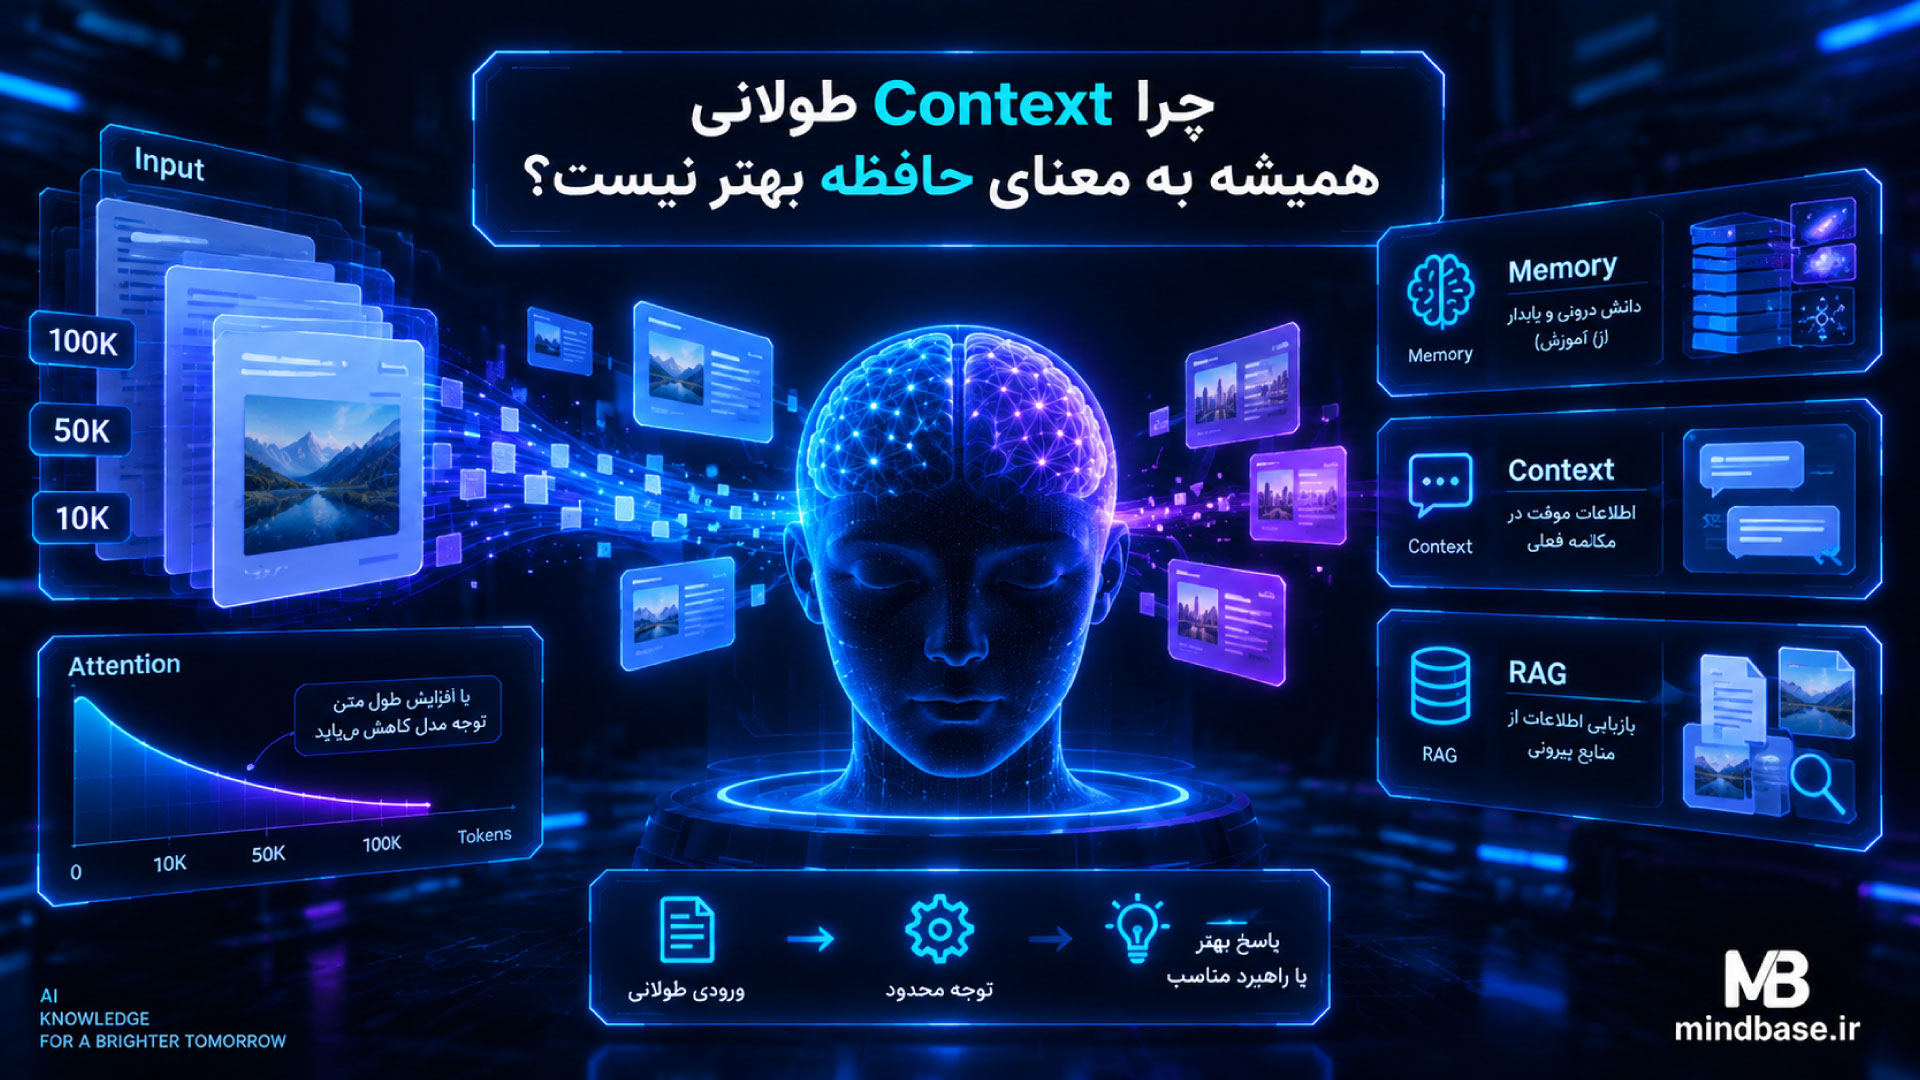
چرا Context طولانی همیشه به معنای حافظه بهتر نیست؟
Context Window چیست؟
Context Window محدودهای از Tokenهاست که مدل میتواند در یک درخواست یا فرآیند تولید در اختیار داشته باشد.
اگر مدلی Context Window برابر 128K Token داشته باشد، یعنی میتواند تا حدود 128 هزار Token را در محدوده Context پردازش کند.
این عدد را نباید با حافظه دائمی مدل اشتباه گرفت.
Context یک فضای کاری است که اطلاعات موردنیاز مدل در آن قرار میگیرد.
برای مثال ممکن است Context شامل این موارد باشد:
- پیامهای قبلی مکالمه
- سؤال فعلی کاربر
- دستورهای سیستم
- فایلهای ارسالشده
- نتایج جستجو
- اطلاعات بازیابیشده از RAG
- خروجی ابزارها
- کدهای پروژه
- اسناد و مقالات
مدل با استفاده از این اطلاعات پاسخ تولید میکند.
بنابراین:
Context Window = ظرفیت دریافت و پردازش اطلاعات
نه:
Context Window = حافظه دائمی
Hugging Face نیز Context Length را به حداکثر تعداد Tokenهایی که مدل میتواند پردازش کند و دامنه توجه مدل مرتبط میکند.
Context بزرگ چه مزیتی دارد؟
Context بزرگ واقعاً مفید است.
فرض کنید میخواهید یک مدل هوش مصنوعی یک کتاب کامل را تحلیل کند.
اگر مدل فقط چند هزار Token ظرفیت داشته باشد، احتمالاً مجبور میشوید کتاب را به بخشهای کوچک تقسیم کنید.
اما اگر مدل بتواند صدها هزار Token را در یک Context پردازش کند، میتوان بخش بسیار بزرگتری از کتاب را همزمان در اختیار آن قرار داد.
این قابلیت برای کارهایی مانند موارد زیر بسیار ارزشمند است:
- تحلیل اسناد طولانی
- بررسی قراردادها
- تحلیل کدهای بزرگ
- خلاصهسازی کتاب
- بررسی گزارشهای مالی
- تحلیل پروژههای نرمافزاری
- پردازش تاریخچه مکالمات
- تحقیق روی مجموعهای از اسناد
- اجرای Agentهای طولانیمدت
پس Context بزرگ یک قابلیت مهم است.
مشکل از جایی شروع میشود که آن را با «حافظه بهتر» یکی بدانیم.
ظرفیت بیشتر با حافظه بهتر یکی نیست
فرض کنید دو مدل داریم.
مدل اول:
128K Context
مدل دوم:
1M Context
در نگاه اول ممکن است نتیجه بگیریم مدل دوم تقریباً هشت برابر حافظه بهتری دارد.
اما چنین نتیجهای از نظر فنی درست نیست.
مدل دوم فقط میتواند حجم بسیار بیشتری از Tokenها را در یک Context دریافت کند.
این موضوع تضمین نمیکند که وقتی اطلاعات موردنظر شما در میان صدها هزار Token قرار گرفت، مدل بتواند آن را با همان دقتی که یک متن کوتاه را پردازش میکند پیدا و استفاده کند.
این تفاوت بسیار مهم است:
Context Capacity
با
Context Utilization
یکی نیست.
یک مثال ساده
فرض کنید یک قرارداد 500 صفحهای را به مدل بدهید.
در صفحه 3 نوشته شده:
«شرکت موظف است مبلغ قرارداد را تا روز پانزدهم هر ماه پرداخت کند.»
و شما در صفحه 420 میپرسید:
«مهلت پرداخت چیست؟»
مدل ممکن است پاسخ صحیح بدهد.
اما اگر اطلاعات مهم را در میان صدها هزار Token، بین تعداد زیادی بخش نامرتبط، جدول، توضیح و سند قرار دهید، پیدا کردن اطلاعات موردنظر برای مدل میتواند دشوارتر شود.
بنابراین:
داشتن اطلاعات در Context
با
استفاده مؤثر از اطلاعات موجود در Context
تفاوت دارد.
پدیده Lost in the Middle چیست؟
یکی از معروفترین مشکلات Long Context با عنوان:
Lost in the Middle
شناخته میشود.
ایده اصلی این است که مدلهای زبانی همیشه اطلاعات موجود در تمام نقاط Context را با کیفیت یکسان استفاده نمیکنند.
پژوهش معروفی که در مجموعه Papers مربوط به Hugging Face نیز نمایه شده، نشان داد عملکرد مدلها در برخی وظایف زمانی بهتر است که اطلاعات مرتبط در ابتدای Context یا انتهای آن قرار داشته باشد و وقتی اطلاعات موردنیاز در وسط Context قرار میگیرد، عملکرد میتواند به شکل قابل توجهی کاهش پیدا کند. این مشکل حتی در مدلهایی که برای Contextهای طولانی طراحی شدهاند نیز مشاهده شده است.
به بیان ساده:
مدل ممکن است اطلاعات را ببیند، اما لزوماً به آن به اندازه کافی توجه نکند.
این تفاوت بسیار مهم است.
چرا اطلاعات وسط Context گم میشود؟
مدلهای Transformer از مکانیزم Attention برای محاسبه ارتباط بین Tokenها استفاده میکنند.
Attention کمک میکند مدل هنگام پردازش یک Token، ارتباط آن با بخشهای دیگر ورودی را در نظر بگیرد. Hugging Face نیز Attention را یکی از اجزای اصلی معماری Transformer معرفی میکند که به مدل اجازه میدهد روابط میان Tokenها را در نظر بگیرد.
اما وقتی تعداد Tokenها بسیار زیاد میشود، مسئله پیچیدهتر میشود.
فرض کنید به جای 500 Token، مدل باید صدها هزار Token را بررسی کند.
اکنون تعداد بسیار زیادی رابطه بالقوه بین بخشهای مختلف متن وجود دارد.
مدل باید تشخیص دهد:
کدام اطلاعات مهم است؟
کدام اطلاعات بیاهمیت است؟
کدام جمله به سؤال فعلی مربوط است؟
کدام بخش صرفاً نویز است؟
این کار با افزایش Context سادهتر نمیشود.
در بعضی شرایط حتی دشوارتر میشود.
Attention با Context طولانی چه مشکلی دارد؟
در Attention کامل، محاسبات مربوط به Tokenهای ورودی با طول توالی رشد میکنند.
مستندات Hugging Face توضیح میدهند که در Self-Attention استاندارد، ماتریس Attention ابعادی متناسب با مربع طول توالی دارد. به همین دلیل افزایش شدید طول ورودی میتواند هزینه محاسباتی و مصرف حافظه را بسیار افزایش دهد.
به صورت ساده:
تعداد Token بیشتر
↓
محاسبات بیشتر
↓
حافظه بیشتر
↓
هزینه بیشتر
البته معماریهای جدید و روشهایی مانند Flash Attention، GQA، MQA، Sparse Attention و روشهای دیگر تلاش میکنند این هزینه را کاهش دهند. Hugging Face نیز Flash Attention و معماریهایی مانند MQA و GQA را از روشهای مهم برای بهبود کارایی مدلها در Contextهای طولانی معرفی میکند.
بنابراین مدلها میتوانند Contextهای بسیار بزرگتری را پردازش کنند، اما این کار بدون هزینه نیست.
Context طولانی همیشه ارزان نیست
فرض کنید یک درخواست ساده دارید:
«این متن را خلاصه کن.»
اگر متن فقط 2 هزار Token باشد، پردازش آن نسبتاً سادهتر است.
حالا همان درخواست را با 500 هزار Token تصور کنید.
حتی اگر مدل بتواند چنین Contextی را قبول کند، پردازش این حجم از اطلاعات منابع محاسباتی بسیار بیشتری نیاز دارد.
این مسئله در سرویسهای API اهمیت بیشتری پیدا میکند، چون بسیاری از سرویسها هزینه را براساس Token محاسبه میکنند.
بنابراین Context بزرگ میتواند هزینه بیشتری ایجاد کند.
افزایش Context میتواند سرعت را هم تحت تأثیر قرار دهد
در یک سیستم واقعی فقط کیفیت پاسخ مهم نیست.
سرعت پاسخ نیز اهمیت دارد.
هرچه ورودی بزرگتر باشد، مدل باید اطلاعات بیشتری را در فرآیند پردازش اولیه بررسی کند.
این مرحله معمولاً به عنوان Prefill شناخته میشود.
در نتیجه یک Context بسیار بزرگ میتواند زمان و منابع بیشتری مصرف کند.
برای Agentهایی که دائماً اطلاعات جدید به Context اضافه میکنند، این مسئله اهمیت بیشتری پیدا میکند.
فرض کنید یک Agent در طول چند ساعت فعالیت خود صدها هزار Token تولید کرده باشد.
اگر قرار باشد تمام تاریخچه را در هر مرحله دوباره وارد Context کنیم، سیستم به تدریج بسیار سنگین میشود.
به همین دلیل مدیریت Context یکی از موضوعات مهم در طراحی Agentهای طولانیمدت است.
Context طولانی با حافظه بلندمدت چه تفاوتی دارد؟
این همان نکتهای است که در مقاله قبلی درباره Memory، Context و RAG بررسی کردیم.
Context میتواند شامل اطلاعات زیادی باشد، اما معمولاً فضای کاری فعلی مدل است.
Memory میتواند اطلاعات مهم را برای استفاده در آینده ذخیره کند.
RAG میتواند اطلاعات مرتبط را از یک منبع خارجی بازیابی کند.
بنابراین یک سیستم حرفهای لازم نیست تمام تاریخچه زندگی یک کاربر را همیشه داخل Context نگه دارد.
میتواند:
اطلاعات مهم را ذخیره کند
↓
در زمان مناسب آنها را بازیابی کند
↓
فقط اطلاعات مرتبط را وارد Context کند
این معماری معمولاً بسیار منطقیتر از این است که کل تاریخچه را تا ابد به مدل بچسبانیم.
آیا میتوان تمام مکالمه را در Context نگه داشت؟
از نظر فنی، اگر Context Window اجازه دهد، ممکن است.
اما از نظر طراحی سیستم همیشه تصمیم خوبی نیست.
فرض کنید یک کاربر طی یک سال هزاران پیام ارسال کرده باشد.
اگر تمام آنها را در هر درخواست به مدل بدهیم:
- تعداد Tokenها بسیار زیاد میشود
- هزینه افزایش پیدا میکند
- زمان پردازش بیشتر میشود
- اطلاعات نامرتبط افزایش پیدا میکند
- احتمال گم شدن اطلاعات مهم بیشتر میشود
- مدیریت Context دشوارتر میشود
در چنین شرایطی، حافظه هوشمند بهتر از تاریخچه خام است.
Context Rot چیست؟
یکی از مفاهیم مرتبط با این موضوع، Context Rot است.
منظور از آن این است که با افزایش حجم Context، عملکرد مدل در استفاده مؤثر از اطلاعات میتواند افت کند.
این موضوع نشان میدهد که ظرفیت Context صرفاً یک عدد روی برگه مشخصات نیست.
ممکن است یک مدل از نظر فنی بتواند یک میلیون Token دریافت کند، اما کیفیت استفاده از تمام آن یک میلیون Token با کیفیت استفاده از 10 هزار Token یکسان نباشد.
بنابراین هنگام ارزیابی مدل باید دو سؤال جداگانه پرسید:
مدل چند Token را میپذیرد؟
و:
مدل با این تعداد Token چقدر خوب کار میکند؟
این دو سؤال را نباید یکی فرض کرد.
Long Context واقعی با Long Context روی کاغذ فرق دارد
فرض کنید شرکتی اعلام کند:
Context Window: 1,000,000 Token
این عدد جذاب است.
اما برای ارزیابی واقعی باید چیزهای بیشتری بررسی شود.
مثلاً:
- آیا مدل اطلاعات مهم را در ابتدای Context پیدا میکند؟
- آیا اطلاعات وسط Context را هم پیدا میکند؟
- آیا با چند سند همزمان عملکرد خوبی دارد؟
- آیا با اطلاعات تکراری گیج میشود؟
- آیا با افزایش طول Context کیفیت پاسخ کاهش پیدا میکند؟
- آیا مدل در Contextهای بسیار بزرگ دچار افت استدلال میشود؟
- آیا هزینه و سرعت استفاده قابل قبول است؟
پس:
1M Context ≠ تضمین عملکرد عالی روی 1M Token
چرا Benchmarkهای Long Context مهم هستند؟
برای اینکه فقط اعلام Context Window کافی نیست، مدلها باید روی آزمونهایی ارزیابی شوند که توانایی واقعی آنها در استفاده از Context طولانی را بررسی کنند.
یکی از مشکلات Benchmarkهای ساده این است که ممکن است فقط یک قطعه اطلاعات مشخص را داخل Context قرار دهند و از مدل بخواهند آن را پیدا کند.
اما استفاده واقعی پیچیدهتر است.
در دنیای واقعی ممکن است:
- صدها سند داشته باشید
- اطلاعات تکراری وجود داشته باشد
- چند سند اطلاعات متناقض داشته باشند
- اطلاعات مهم در وسط قرار گرفته باشد
- سؤال نیازمند ترکیب چند سند باشد
- پاسخ نیازمند استدلال چندمرحلهای باشد
بنابراین آزمون واقعی Long Context باید فراتر از این باشد که:
«آیا مدل توانست یک جمله را پیدا کند؟»
چرا اطلاعات اضافی میتواند به مدل آسیب بزند؟
فرض کنید سؤال شما فقط درباره یک قرارداد خاص است.
اما شما 100 قرارداد را به مدل میدهید.
از نظر تئوری اطلاعات بیشتری در اختیار مدل قرار گرفته است.
اما همه این اطلاعات مفید نیستند.
ممکن است قراردادهای مختلف:
- نامهای مشابه داشته باشند
- اعداد مشابه داشته باشند
- بندهای مشابه داشته باشند
- شرایط متفاوت داشته باشند
حالا مدل باید ابتدا تشخیص دهد کدام سند مرتبط است.
بنابراین:
اطلاعات بیشتر همیشه به معنی اطلاعات بهتر نیست.
در بسیاری از سیستمهای AI، هدف اصلی این نیست که بیشترین اطلاعات ممکن را به مدل بدهیم.
هدف این است که:
مرتبطترین اطلاعات ممکن را در اختیار مدل قرار دهیم.
RAG در اینجا چه کمکی میکند؟
RAG دقیقاً در چنین شرایطی ارزشمند میشود.
فرض کنید یک شرکت یک میلیون سند دارد.
به جای اینکه تمام یک میلیون سند را در Context قرار دهیم، میتوانیم:
سؤال کاربر
↓
Retrieval
↓
پیدا کردن اسناد مرتبط
↓
انتخاب بخشهای مهم
↓
ساخت Context کوچکتر و مرتبطتر
↓
ارسال به مدل
در این معماری، Context ممکن است بسیار کوچکتر باشد، اما کیفیت اطلاعات آن بیشتر باشد.
این یعنی:
Context کمتر، اما مرتبطتر
میتواند از:
Context بیشتر، اما پر از نویز
بهتر باشد.
آیا Context بزرگ جای RAG را میگیرد؟
نه لزوماً.
حتی اگر مدل Context بسیار بزرگی داشته باشد، استفاده از Retrieval همچنان میتواند منطقی باشد.
فرض کنید مدل میتواند یک میلیون Token دریافت کند.
اگر پایگاه دانش شما 100 میلیون Token باشد، باز هم نمیتوانید همه آن را در یک Context قرار دهید.
از طرف دیگر، حتی اگر بتوانید مقدار بسیار زیادی از اطلاعات را وارد Context کنید، ممکن است انجام این کار از نظر هزینه و کیفیت پاسخ بهینه نباشد.
RAG میتواند قبل از رسیدن اطلاعات به مدل، بخش مرتبط را انتخاب کند.
بنابراین:
Long Context و RAG رقیب مستقیم نیستند.
در بسیاری از معماریها این دو مکمل یکدیگرند.
Context Management چیست؟
Context Management مجموعه تکنیکهایی است که برای کنترل اطلاعات موجود در Context استفاده میشود.
یک سیستم Context Management میتواند تصمیم بگیرد:
- چه چیزی وارد Context شود
- چه چیزی حذف شود
- چه چیزی خلاصه شود
- چه چیزی در Memory ذخیره شود
- چه چیزی از RAG بازیابی شود
- چه چیزی به تاریخچه منتقل شود
- چه اطلاعاتی اولویت بیشتری دارد
برای یک Agent حرفهای، این مسئله بسیار مهم است.
چون Agent ممکن است ساعتها کار کند و در طول این مدت حجم عظیمی از اطلاعات تولید کند.
خلاصهسازی تاریخچه چگونه کمک میکند؟
فرض کنید مکالمهای 100 هزار Token شده است.
قرار نیست تمام 100 هزار Token برای همیشه با همان جزئیات در Context باقی بماند.
سیستم میتواند بخشهای قدیمیتر را خلاصه کند.
مثلاً:
به جای نگه داشتن 20 هزار Token مکالمه:
خلاصه:
«کاربر در پروژه X از Laravel استفاده میکند. معماری انتخاب شده Modular Monolith است. احراز هویت با Laravel Sanctum انجام میشود. بخش پرداخت هنوز پیادهسازی نشده است.»
حالا مدل به جای 20 هزار Token، یک خلاصه کوچک دریافت میکند.
البته خلاصهسازی نیز خطر خودش را دارد.
اگر اطلاعات مهم در زمان خلاصهسازی حذف شود، مدل دیگر به آن دسترسی نخواهد داشت.
پس Context Management خودش یک مسئله مهندسی جدی است.
آیا خلاصهسازی همیشه بهتر از Context طولانی است؟
نه.
اگر اطلاعات بسیار دقیق و حساس باشند، خلاصهسازی ممکن است جزئیات مهم را حذف کند.
مثلاً در یک قرارداد:
«پرداخت در روز پانزدهم انجام میشود.»
ممکن است در خلاصه تبدیل شود به:
«پرداخت ماهانه انجام میشود.»
اطلاعات مهم از بین رفته است.
به همین دلیل سیستمهای حرفهای معمولاً ترکیبی از روشها را استفاده میکنند:
- Context کوتاهمدت
- Summary
- Memory
- RAG
- ذخیره اسناد اصلی
به جای اینکه فقط یک روش را برای همه چیز استفاده کنند.
Context طولانی و Agentها
Agentها یکی از مهمترین جاهایی هستند که مشکل Context خودش را نشان میدهد.
فرض کنید یک Coding Agent برای چند ساعت روی یک پروژه کار میکند.
در طول کار:
- فایل میخواند
- کد مینویسد
- تست اجرا میکند
- خطا دریافت میکند
- اصلاح میکند
- دوباره تست میکند
- مستندات میخواند
- با ابزارهای مختلف کار میکند
اگر همه این اتفاقات بدون هیچ مدیریت Context در تاریخچه باقی بمانند، تعداد Tokenها به سرعت افزایش پیدا میکند.
Hugging Face نیز در مطالب مربوط به Long Context Training به همین روند اشاره میکند که Agentهای طولانیمدت میتوانند طی جلسات کاری صدها هزار Token جمع کنند و مدلهای جدید برای چنین سناریوهایی به Contextهای بسیار بزرگ نیاز پیدا کردهاند.
پس Agentهای پیشرفته فقط به Context بزرگ نیاز ندارند.
آنها به مدیریت هوشمند Context نیاز دارند.
آیا Context بیشتر باعث استدلال بهتر میشود؟
نه به صورت خودکار.
داشتن اطلاعات بیشتر میتواند به استدلال کمک کند، اما فقط زمانی که مدل بتواند اطلاعات مرتبط را پیدا و به شکل درست ترکیب کند.
اگر Context پر از اطلاعات نامرتبط باشد، مدل ممکن است مجبور شود میان حجم زیادی از دادهها ارتباط برقرار کند.
در نتیجه افزایش Context میتواند هم مزیت باشد و هم چالش.
این موضوع شبیه اضافه کردن کتابهای بیشتر به یک میز کار است.
داشتن 100 کتاب بهتر از داشتن 2 کتاب است، اگر کتاب موردنظر را بتوانید پیدا کنید.
اگر همه 100 کتاب روی میز ریخته باشند و صفحه موردنظر را پیدا نکنید، تعداد کتابها چندان کمکی نمیکند.
Context Quality مهمتر از Context Quantity
یکی از مهمترین اصول طراحی سیستمهای LLM این است:
کیفیت Context میتواند از اندازه Context مهمتر باشد.
یک Context خوب باید:
- مرتبط باشد
- اطلاعات تکراری کمی داشته باشد
- اطلاعات متناقض را کنترل کند
- اطلاعات مهم را حفظ کند
- ساختار مناسبی داشته باشد
- به سؤال فعلی مرتبط باشد
در مقابل، یک Context ضعیف ممکن است:
- بسیار طولانی باشد
- اطلاعات نامرتبط زیادی داشته باشد
- شامل نسخههای قدیمی اطلاعات باشد
- دادههای متناقض داشته باشد
- باعث افزایش هزینه شود
بنابراین هدف سیستم هوش مصنوعی نباید:
بیشترین Context ممکن
باشد.
بلکه باید:
بهترین Context ممکن
باشد.
آیا مدلهای جدید مشکل Context طولانی را حل کردهاند؟
مدلهای جدید پیشرفت بسیار زیادی در Long Context داشتهاند.
Contextهای 128K، 256K، 1M Token و حتی بیشتر، اکنون در برخی مدلها و پروژهها مطرح هستند.
روشهای معماری، آموزش و بهینهسازی نیز امکان پردازش توالیهای طولانیتر را فراهم کردهاند. برای مثال Hugging Face در مستندات Long Context Training نشان میدهد که آموزش توالیهای حدود یک میلیون Token به روشهای توزیعشده و تکنیکهایی مانند Context Parallelism نیاز دارد.
اما بزرگتر شدن ظرفیت به معنی حل کامل مسئله نیست.
مدل باید برای استفاده مؤثر از Context طولانی نیز آموزش و ارزیابی شده باشد.
Context Window را چگونه باید ارزیابی کنیم؟
وقتی مشخصات یک مدل را بررسی میکنید، فقط به عدد Context Window نگاه نکنید.
بهتر است این موارد را نیز بررسی کنید:
1. حداکثر Context
مدل چند Token را قبول میکند؟
2. عملکرد در Contextهای مختلف
آیا کیفیت پاسخ با افزایش طول ورودی کاهش پیدا میکند؟
3. موقعیت اطلاعات
آیا مدل اطلاعات ابتدای Context و انتهای Context را بهتر از وسط آن پیدا میکند؟
4. کیفیت Retrieval
آیا مدل میتواند اطلاعات مرتبط را از میان اسناد زیاد پیدا کند؟
5. استدلال
آیا مدل میتواند اطلاعات چند قسمت مختلف را با هم ترکیب کند؟
6. هزینه
پردازش Context بزرگ چقدر هزینه دارد؟
7. سرعت
مدل در Contextهای طولانی چقدر سریع پاسخ میدهد؟
8. کاربرد واقعی
آیا عملکرد مدل در سناریوی واقعی شما مناسب است؟
این موارد بسیار مهمتر از یک عدد بزرگ در صفحه معرفی مدل هستند.
تفاوت Context Length و Context Utilization
این دو اصطلاح را بهتر است همیشه از هم جدا کنیم.
Context Length
حداکثر طول Context قابل پردازش است.
Context Utilization
توانایی مدل در استفاده مؤثر از اطلاعات موجود در آن Context است.
مثلاً:
مدل A:
Context: 1M
ولی در Contextهای بسیار طولانی عملکرد آن افت شدیدی دارد.
مدل B:
Context: 256K
ولی اطلاعات را در این محدوده بسیار دقیقتر پیدا و ترکیب میکند.
برای یک کاربرد واقعی، مدل B ممکن است انتخاب بهتری باشد.
بنابراین:
بزرگتر بودن Context همیشه به معنای بهتر بودن مدل نیست.
بهترین Context چه شکلی است؟
بهترین Context لزوماً بزرگترین Context نیست.
یک Context خوب باید به مدل کمک کند سریعتر بفهمد:
چه چیزی مهم است؟
چه چیزی مرتبط است؟
چه چیزی باید نادیده گرفته شود؟
برای همین در طراحی سیستمهای حرفهای، معمولاً ترکیبی از این تکنیکها استفاده میشود:
Context کوتاه و مرتبط
Memory برای اطلاعات پایدار
RAG برای دانش خارجی
Summary برای تاریخچه طولانی
Tool Calling برای اطلاعات و اقدامات لحظهای
این معماری معمولاً از ریختن تمام اطلاعات ممکن داخل Context نتیجه بهتری میدهد.
آیا باید همیشه اطلاعات بیشتری به مدل بدهیم؟
خیر.
این یکی از رایجترین اشتباهات هنگام ساخت Prompt و سیستمهای RAG است.
فرض میکنیم:
«اگر اطلاعات بیشتر بدهیم، مدل بهتر جواب میدهد.»
اما این رابطه خطی نیست.
گاهی اضافه کردن اطلاعات بیشتر باعث میشود مدل:
- تمرکز خود را از دست بدهد
- اطلاعات مهم را سختتر پیدا کند
- با دادههای متناقض مواجه شود
- Token بیشتری مصرف کند
- پاسخ طولانیتر و ضعیفتری تولید کند
پس هنگام طراحی Prompt بهتر است به جای پرسیدن:
چه اطلاعات بیشتری میتوانم اضافه کنم؟
بپرسیم:
کدام اطلاعات واقعاً برای این پاسخ لازم است؟
این تفاوت کوچک، سیستمهای AI را از Promptهای شلوغ و بیمصرف جدا میکند.
آینده Context در مدلهای هوش مصنوعی
احتمالاً Context Window همچنان بزرگتر خواهد شد.
مدلها قادر خواهند بود اسناد بیشتر، تاریخچه طولانیتر و پروژههای بزرگتری را در یک فرآیند پردازش کنند.
اما همزمان، معماریهای مدیریت Context نیز اهمیت بیشتری پیدا خواهند کرد.
به جای اینکه مدل را با میلیونها Token بمباران کنیم، سیستمهای آینده احتمالاً بهتر تشخیص خواهند داد:
- چه چیزی را نگه دارند
- چه چیزی را خلاصه کنند
- چه چیزی را بازیابی کنند
- چه چیزی را فراموش کنند
- چه چیزی را در Memory ذخیره کنند
- چه چیزی را در لحظه از ابزارها دریافت کنند
بنابراین آینده AI فقط درباره:
Context بزرگتر
نیست.
بلکه درباره:
Context هوشمندتر
است.
جمعبندی
Context Window بزرگ یکی از مهمترین پیشرفتهای مدلهای زبانی است، اما نباید آن را با حافظه بهتر یکی دانست.
Context فقط ظرفیت اطلاعاتی است که مدل میتواند در یک فرآیند پردازش دریافت کند.
اینکه مدل بتواند 1 میلیون Token دریافت کند، به این معنی نیست که میتواند تمام اطلاعات موجود در آن را با کیفیت یکسان پیدا، درک و استفاده کند.
پدیدههایی مانند Lost in the Middle نشان دادهاند که مدلها ممکن است در Contextهای طولانی، اطلاعات قرارگرفته در بخش میانی را ضعیفتر بازیابی کنند و با افزایش طول Context نیز عملکرد برخی وظایف کاهش پیدا کند.
از طرف دیگر، پردازش Context طولانی هزینه محاسباتی و حافظهای بیشتری دارد و معماریهای مختلفی برای کاهش این هزینه توسعه داده شدهاند.
به همین دلیل یک سیستم هوش مصنوعی حرفهای نباید صرفاً به دنبال بیشترین Context ممکن باشد.
بهتر است از ترکیبی از:
Context
Memory
RAG
Summary
Context Management
و Tools
استفاده کند.
در نهایت، تفاوت اصلی این دو جمله را به خاطر بسپارید:
«مدل میتواند اطلاعات زیادی ببیند.»
با:
«مدل میتواند از اطلاعات زیادی بهخوبی استفاده کند.»
یکی نیست.
Context بزرگتر ظرفیت بیشتری میدهد، اما حافظه و هوش بهتر را تضمین نمیکند. در سیستمهای واقعی، کیفیت، ارتباط و مدیریت Context اغلب از صرفاً بزرگتر بودن آن مهمتر هستند.