
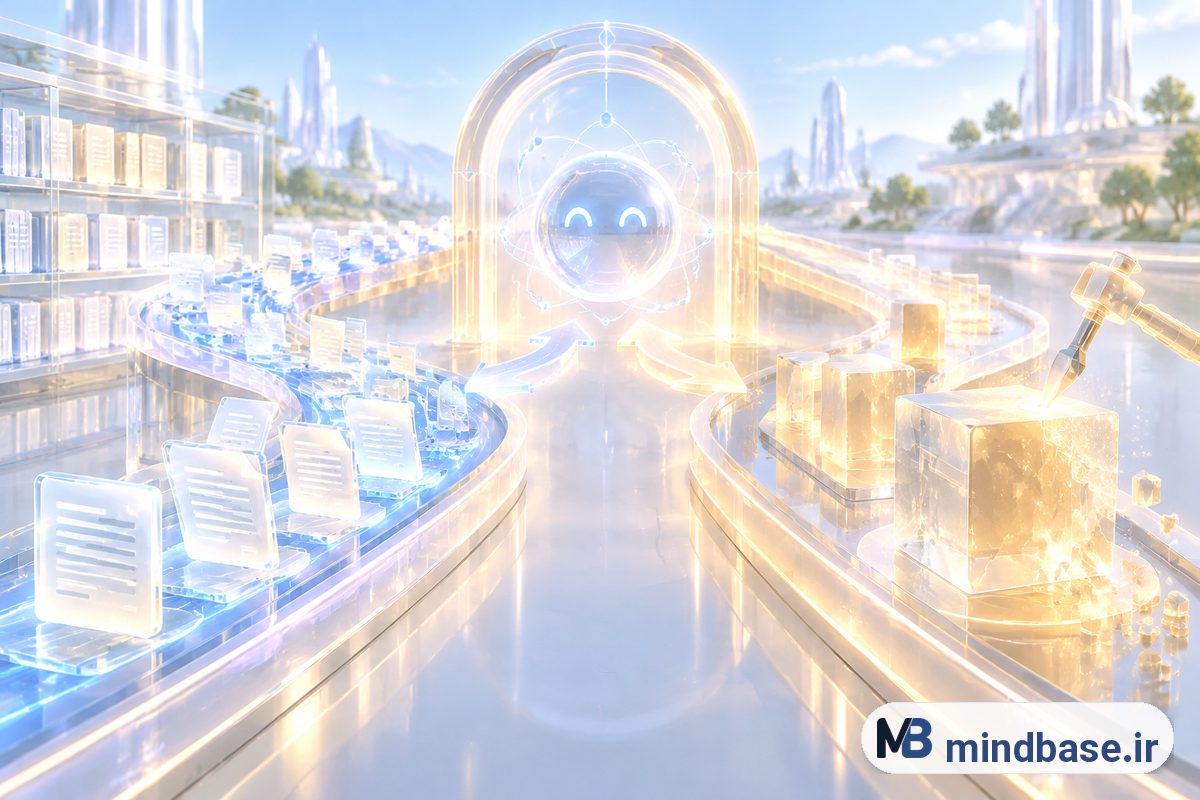
هر تیمی که میخواهد مدل زبانی را برای کار خودش «تنظیم» کند، دیر یا زود به این دوراهی میرسد: RAG یا Fine-tuning؟ بدترین جواب، «هر دو خوباند» است؛ چون انتخاب اشتباه هزینه دارد: دانش متغیر را با Fine-tuning قفل کنید و هر ماه بازآموزی، یا رفتار مدل را با پرامپتهای عظیم هر بار پول بدهید. در این مطلب تفاوت بنیادین را باز میکنیم و چارچوبی میدهیم که با آن بتوانید برای هر نیاز، تصمیم بگیرید.
تفاوت بنیادین: دو سؤال متفاوت
دو ابزار دو سؤال متفاوت را جواب میدهند. RAG به این سؤال جواب میدهد: «مدل از کجا بخواند؟» — دانش را در بیرون مدل نگه میدارد و در لحظهی پاسخ، بخش مرتبط را میآورد. Fine-tuning به این سؤال جواب میدهد: «مدل چطور جواب بدهد؟» — رفتار، سبک و قالب را در وزنهای خود مدل تثبیت میکند. هر وقت جملهی نیازتان با «چه چیزی را بداند» شروع شد، سمت RAG نگاه کنید؛ هر وقت با «چگونه رفتار کند» شروع شد، سمت تنظیم دقیق.
RAG کتابخانهی بهروز کنار مدل است؛ Fine-tuning عادتهای حرفهای داخل خود مدل. کتابخانه جای عادت را نمیگیرد و برعکس.
مقایسه در پنج معیار عملی
- بهروزرسانی: RAG با تغییر سند، لحظهای بهروز میشود؛ Fine-tuning هر تغییر دانش یعنی چرخهی داده و بازآموزی. برای محتوای متغیر — قیمت، قوانین، محصولات — این معیار تقریباً قاطع است.
- قابل ردیابی بودن: RAG منبع میدهد؛ پاسخ قابل بازبینی و اعتمادسازی است. در Fine-tuning، دانش در وزنها «ذوب» شده و ارجاعی وجود ندارد — برای حوزههای حساس نقطهضعف جدی.
- هزینه و زمان شروع: RAG با چند هفته و زیرساخت ساده شروع میشود؛ Fine-tuning به دادهی باکیفیت نیاز دارد — و داده معمولاً گرانترین بخش است.
- حریم داده: در RAG اسناد در زیرساخت شما میمانند و فقط تکهی لازم به مدل میرود؛ در Fine-tuning داده در آموزش «جذب» میشود و ملاحظات مالکیت و حذف پیچیدهتر است.
- اثر بر رفتار: RAG رفتار مدل را عوض نمیکند — همان سبک همیشگی با متن تازه؛ Fine-tuning رفتار را واقعاً تغییر میدهد اما ریسک افت تواناییهای عمومی را هم دارد.
جدول تصمیم: نیاز شما کدام است؟
- «مدل مستندات ما را نمیداند» ← RAG
- «پاسخها باید از آخرین دادهها بیاید» ← RAG
- «باید به سند ارجاع بدهد» ← RAG
- «جوابها باید با لحن و قالب برند باشد» ← Fine-tuning
- «خروجی باید همیشه ساختار ثابت سیستم ما را داشته باشد» ← Fine-tuning (یا پرامپت دقیق اگر حجم کم است)
- «کار تخصصی ما الگوی خاص خودش را دارد» ← Fine-tuning با دادهی واقعی
- «هم دانش میخواهیم هم رفتار» ← ترکیب هر دو
الگوی ترکیبی: آنچه سیستمهای بلوغیافته میکنند
در عمل، پروژههای موفق هر دو را با تقسیم کار واضح دارند: RAG ستون دانش است — مستندات بهروز، بازیابی معنایی، پاسخ مستند؛ Fine-tuning (معمولاً با روش کمهزینهی LoRA) لایهی رفتار است — سبک سازمان، قالب گزارش، آداب ارجاعدهی. ترتیب پیشنهادی پیادهسازی هم مهم است: اول RAG چون سریعتر به ارزش میرسد و پایهی ارزیابی را میسازد؛ بعد اگر پس از دو ماه استفاده، شکایتها «شکلی» بود نه «محتوایی» — یعنی جواب درست میآید اما قالبش با سیستم نمیخواند — آنجا تنظیم دقیق را وارد کنید. این ترتیب، ریسک و هزینه را کمینه میکند.
سه اشتباه رایج
- Fine-tuning برای دانش: رایجترین و پرهزینهترین؛ مدل با دادهی امروز آموزش میبیند و سه ماه بعد منقضی است.
- RAG بدون ارزیابی: سیستم ساخته میشود اما کسی نمیداند بازیابی در چند درصد مواقع درست کار میکند؛ موضوع مطلب ارزیابی RAG دقیقاً همین شکاف را پر میکند.
- پرامپتهای عظیم بهجای هر دو: چسباندن صد سند در هر درخواست، هم هزینه است هم کیفیتکاه؛ همینجاست که معماری RAG — موضوع مطلب RAG چیست — بهروز و ارزان جایگزین میشود.
جمعبندی
دو ابزار، دو سؤال: RAG «از کجا بخواند» و Fine-tuning «چطور جواب بدهد». دانشِ متغیر و نیازمند منبع، کار RAG است؛ رفتار و قالبِ ثابت، کار تنظیم دقیق. از RAG شروع کنید، با داده تصمیم به افزودن Fine-tuning بگیرید و برای اجرا، مدل قوی را از API سازگار با OpenAI مایندبیس بردارید — هر دو مسیر با همین یک کلید باز میشود.