
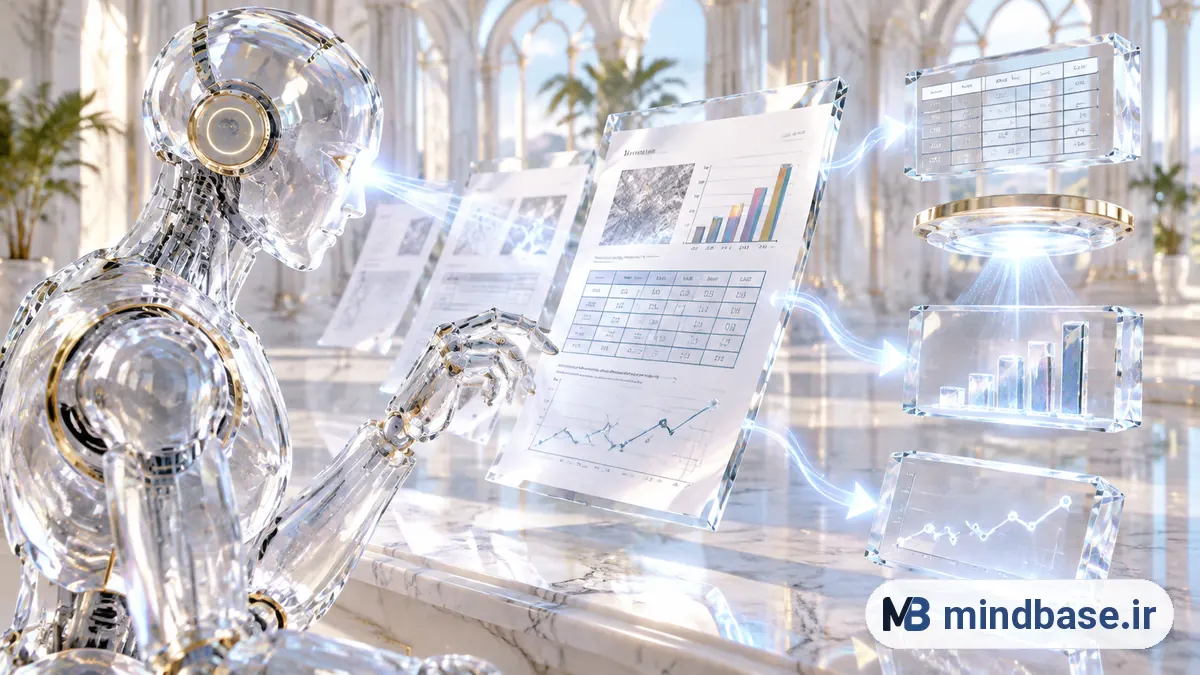
از RAG برای پرسش از مقالات علمی استفاده کردهاید و به جوابهای نصفهنیم رسیدهاید؟ احتمالاً دلیلش این است: سؤال شما دربارهی چیزی بود که در بدنهی متن نبود — در جدول ۳ بود یا در نمودار صفحهی ۵. RAG کلاسیک که فقط متن استخراجشده از PDF را ایندکس میکند، دقیقاً همین نیمهی مهم سند را کورکورانه از دست میدهد. در این مطلب یک چارچوب عملی برای RAG چندوجهی میسازیم که جدولها و نمودارها را واقعاً میبیند، میفهمد و در پاسخ به آنها ارجاع میدهد.
چرا پارس PDF علمی سخت است؟
PDF از نگاه مدل زبانی یک جعبهی سیاه است: جریان کاراکترها بدون منطق چیدمان. سه مشکل کلاسیک: چیدمان دوستونه — استخراج متنِ خام، خط ستونها را با هم قاطی میکند و جملهها بیمعنی میشوند. جدولها — جدول در PDF اغلب فقط خطهای رسمشده است؛ تبدیل به متن یعنی ردیفهای بههمریختهای از اعداد بیسرستون. نمودارها — نمودار یک تصویر است؛ در استخراج متن نه خودش میآید نه اعدادی که نشان میدهد. نتیجه: حتی بهترین مدل، اگر زمینهی خراب برسد، خروجی خراب میدهد — قانون پایهی مهندسی زمینه.
چارچوب چهارمرحلهای
مرحله یک — پارس ساختاری: از استخراج متنِ خام صرفنظر کنید و چیدمان را تحلیل کنید: ابزارهای مدرن پارس سند، عنوانها، پاراگرافها، کپشنها، جدولها و تصاویر را جدا تشخیص میدهند. خروجی این مرحله، «نقشهی سند» است: هر تکه با نوع، شمارهی صفحه و پیوندش به بخش بالادستی. جدولها همینجا به دادهی ساختیافته (مثل Markdown یا JSON) تبدیل میشوند — قبل از هر مدل زبانی.
مرحله دو — توصیفسازی: حالا نوبت مدل چندوجهی است. هر نمودار و شکل را به مدل بدهید و از آن یک توصیف متنی دقیق بخواهید: نوع نمودار، محورها، روند اصلی، اعداد کلیدی. جدولها را هم علاوه بر نسخهی ساختیافته، با یک «خوانش روایی» همراه کنید — جملهای که بگوید این جدول چه مقایسهای را نشان میدهد. این توصیفها پل ورود نمودار به دنیای جستجوی متنیاند.
مرحله سه — ایندکس چندمسیره: برای هر تکه، چند مسیر بازیابی بسازید: متن اصلی، توصیف نمودار، خوانش جدول، و متادیتا (عنوان مقاله، بخش، صفحه). همه را با embedding در یک فضای مشترک ایندکس کنید و در بازیابی ترکیبی استفادهشان کنید. نکتهی مهم: پیوند بین توصیف نمودار و متن اصلی را نگه دارید — پرسشی که در متن شروع میشود، جوابش ممکن است در نمودار باشد و برعکس.
مرحله چهار — پاسخ با ارجاع: در مرحلهی پاسخ، تکههای ساختیافته را به شکل ساختیافته به مدل بدهید — جدول را Markdown بدهید نه متن ریزشده — و از مدل بخواهید به شمارهی صفحه/نمودار/جدول ارجاع بدهد. کاربرِ مقالهی علمی بدون ارجاع به جواب اعتماد نمیکند؛ ارجاع همان «رسید» است که در بحث توهمزایی ضروری دیدیم.
نمودار وقتی وارد سیستم میشود که به جمله تبدیل شده باشد؛ پل بین تصویر و جستجو، توصیف متنی است.
ارزیابی: پرسشهای جدولی را جدا بشمارید
ارزیابی کلی «دقت پاسخ» اینجا گمراهکننده است. مجموعهی ارزیابی را از اول تفکیک کنید: پرسشهای متنی، پرسشهای جدولی («کدام روش در سناریوی B بیشترین خطا را داشته؟») و پرسشهای نموداری («روند پس از ۲۰۱۵ چه بوده؟»). اگر فقط میانگین کلی را ببینید، افت کیفیت پرسشهای نموداری زیر میانگین گم میشود. برای هر گروه جداگانه، کیفیت بازیابی و وفاداری پاسخ را بسنجید — سنجهها در ارزیابی RAG. رایجترین خطای این دامنه هم قابل پیشبینی است: توصیف غلط از نمودار، که بعداً در همهی پاسخهای وابسته به آن نمودار پخش میشود؛ نمونههای دشوار را در حلقهی بازبینی توصیفها برگردانید.
جمعبندی
RAG چندوجهی یعنی به سند بهچشم ساختار نگاه کردن، نه جریان متن: پارس ساختاری، توصیفسازی نمودار و جدول، ایندکس چندمسیره و پاسخ با ارجاع. ترتیب اجرا هم مهم است — بدون پارس ساختاری، بقیه روی دادهی خراب ساخته میشود. این چارچوب را روی سه مقالهی واقعی حوزهی خودتان پیاده کنید و پرسشهای جدولی و نموداری را جدا بسنجید؛ شکافها نقشهی بهبود شماست. برای تجربهی عملی روی اسناد خودتان، یک حساب بسازید.